
Gli errori nell’acquisto dei microfoni sono costosi perché il problema emerge dopo il lancio, in un canale che non puoi raggiungere e perché il prodotto stesso era probabilmente perfetto. Gli errori sono inoltre coerenti tra i diversi fornitori: derivano dalla natura della categoria, non da una specifica azienda, e non è raro trovare una fabbrica che non ha mai sentito parlare di nessuno di questi sei errori.
Quindi la qualità del microfono degli smart glasses e gli errori da evitare nell’acquisto di smart glasses sono in gran parte un elenco di cose che somigliano alla due diligence ma non lo sono. Eccone sei, quanto costa realmente ciascuno e cosa fare invece, perché la versione utile di questo articolo non è un elenco di cose da smettere di fare, ma un insieme di procedure che offrono la stessa tranquillità a un costo inferiore.
Qualità del microfono degli smart glasses: sei errori che sembrano due diligence
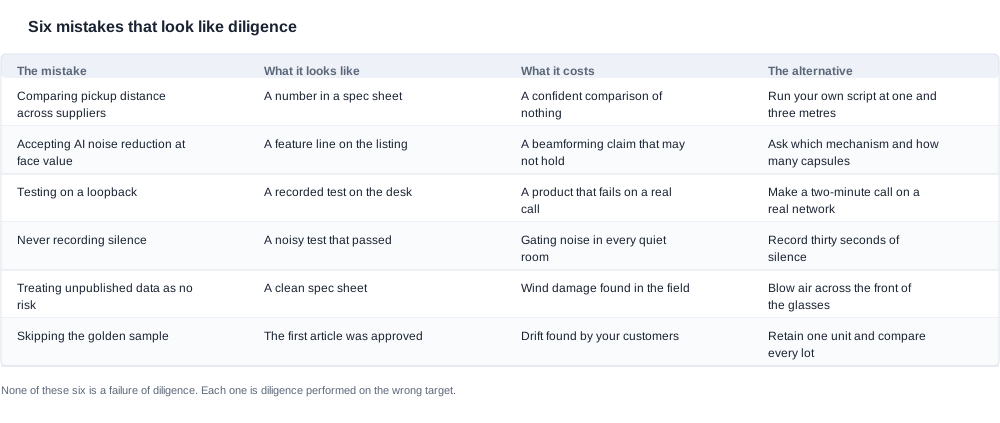
Nessuno di questi sei errori è una mancanza di due diligence. Ciascuno è due diligence eseguita sul bersaglio sbagliato: un confronto effettuato dove serviva una misurazione, un test condotto in un ambiente inesistente oppure l’assenza di dati interpretata come assenza di rischi.
Perché questi errori sono così comuni
C’è una ragione strutturale. La categoria non dispone di specifiche pubblicate su cui basarsi: per nessun modello della nostra gamma sono pubblicati numero di capsule, schema direzionale di ricezione, sensibilità, risposta in frequenza, distanza di captazione, profondità di cancellazione o modello del microfono. In assenza di specifiche, l’acquirente sostituisce la misurazione con il dato più vicino disponibile, ossia le righe pubblicate relative al prodotto: la struttura acustica a orecchio aperto, l’audio direzionale, la riduzione intelligente del rumore, la versione Bluetooth, la capacità della batteria e l’autonomia.
Nessuna di queste righe descrive la qualità del microfono. Descrive il prodotto. Interpretarle come una valutazione del microfono è all’origine dei sei errori seguenti, un errore che capita a quasi tutti coloro che acquistano per la prima volta in questa categoria.
Errori uno e due: confrontare ciò che non è confrontabile
Errore uno: confrontare la distanza di captazione tra fornitori diversi. È l’errore più comune e più dannoso, perché produce un confronto sicuro costruito su nulla.
Una distanza di captazione indicata senza un livello di riferimento dell’input — quanto era forte la sorgente e a quale distanza — non costituisce una misurazione. Due fornitori che dichiarano «cinque metri» potrebbero descrivere condizioni di test completamente diverse, e il dato che compare sulla pagina di un prodotto viene solitamente copiato, non misurato. Non pubblichiamo la distanza di captazione per alcun modello; l’alternativa è semplice: effettua un confronto con il tuo test. Riproduci un passaggio fisso a un metro e a tre metri, registrando dalla posizione in cui si troverebbe la testa. A un metro la maggior parte dei dispositivi passa; a tre metri emergono le differenze.
Errore due: accettare la «riduzione del rumore con AI» alla lettera. L’espressione non indica alcun meccanismo e potrebbe riferirsi a due meccanismi piuttosto diversi.
Il beamforming utilizza due o più capsule disposte secondo una geometria definita per favorire una direzione: è un approccio hardware con specifici requisiti di posizionamento ed è realmente efficace contro un altoparlante concorrente. L’elaborazione con singola capsula è software, funziona attenuando tutto ciò che si trova al di fuori di una direzione target e presenta limiti intrinseci che nessuna quantità di elaborazione può eliminare. I due sistemi vengono venduti con la stessa espressione, ma la differenza di prestazioni contro un altoparlante concorrente è notevole.
Chiedi quale dei due utilizza il prodotto e quante capsule vi partecipano. Un fornitore che non è in grado di rispondere non ha esaminato il design, e questa è una constatazione riguardante il design, non l’onestà del fornitore.
Il numero di capsule è l’unico dato che vale la pena ricercare
Tra tutte le righe mancanti, il numero di capsule è l’unico che modifica il modo in cui valuti tutto il resto ed è anche quello che un fornitore può indicare senza alcun laboratorio.
Una singola capsula con elaborazione e un array a due capsule con beamforming vengono descritte con la stessa espressione in un annuncio, eppure sono prodotti diversi, con comportamenti diversi contro un altoparlante concorrente. L’array richiede una geometria definita per funzionare: le capsule devono essere posizionate e distanziate in modo da produrre una reiezione direzionale, e un array a due capsule mal posizionato ha prestazioni peggiori contro il rumore fuori asse rispetto a una singola capsula ottimamente regolata. Il numero, quindi, non è sufficiente da solo — anche la geometria conta — ma ti dice se hai a che fare con un design hardware o software, e questo determina quali delle altre domande vale la pena fare.
Ti dice anche cosa aspettarti dal vento. Una capsula montata in un’asta aperta non è sigillata in nessuna configurazione, ma un array offre alla catena di elaborazione più informazioni su cui intervenire. Ecco perché il test sul vento riportato in questo articolo viene eseguito sull’unità specifica anziché essere dedotto dalle specifiche.
Le condizioni di misurazione che rendono priva di significato la distanza di captazione
Quattro condizioni devono essere indicate affinché qualsiasi dato sulla capacità di ricezione sia confrontabile con qualcos’altro, e una citazione che ne riporta tre è ancora inutilizzabile.
Il livello della sorgente. La stessa distanza produce risultati completamente diversi tra un sussurro e una voce alzata, e un fornitore che non lo specifica sta citando la versione più semplice del test.
La distanza e l’orientamento. Un metro di fronte non equivale a un metro di lato. Il comportamento fuori asse è esattamente ciò in cui una captazione direzionale dovrebbe essere efficace, quindi l’angolo è il dato che conta ed è proprio quello che viene omesso.
L’ambiente acustico. Una stanza silenziosa e una strada sono ambienti di misura diversi, con dati diversi: citare il risultato obtained in una stanza silenziosa per un prodotto destinato all’uso esterno è il modo in cui un confronto diventa una trappola.
Il criterio di superamento. «Cinque metri» non significa nulla senza il criterio: a quale punteggio di intelligibilità, o rispetto a quale riferimento, i cinque metri sono stati considerati sufficienti? Una misurazione priva di criterio è un’affermazione, e un’affermazione priva di criterio non può essere ripetuta da nessuno, nemmeno da te.
Questa è la forma generale dell’errore. Un dato citato senza le relative condizioni non è un fatto debole; non è un fatto nemmeno, e dovrebbe essere eliminato dal confronto anziché esservi riportato.
Errori tre e quattro: testare la cosa sbagliata
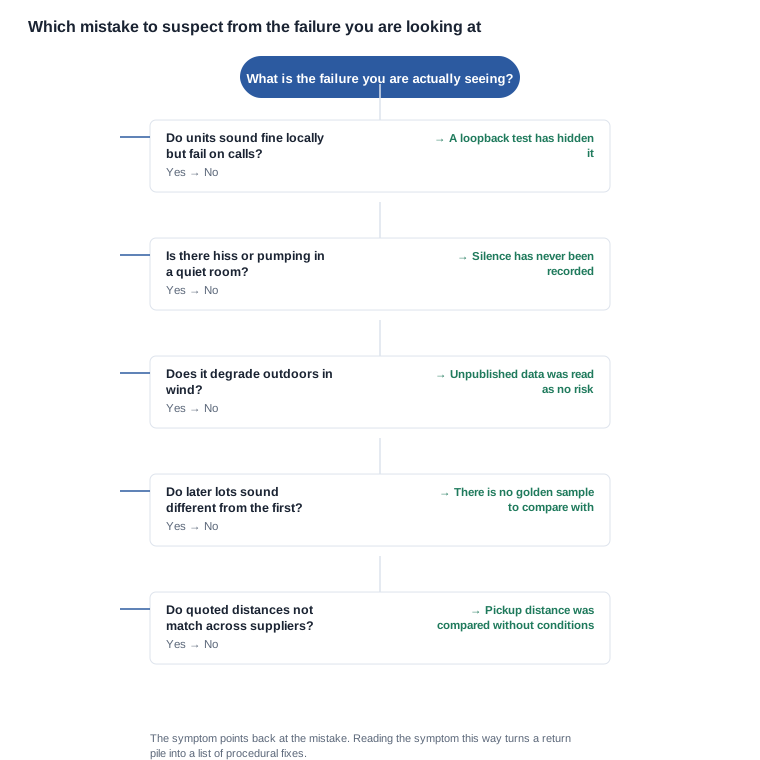
Errore tre: effettuare il test in loopback. Un test in loopback riproduce localmente l’audio. Ignora il comportamento del codec, la perdita di pacchetti e qualsiasi elaborazione che si attiva soltanto su un percorso di rete, che è precisamente dove un wearable fallisce e un telefono no.
Il test che non costa nulla e rileva questo problema consiste neleffettuare una vera chiamata di due minuti su una rete reale, parlando a distanza conversazionale. Se il prodotto funziona bene localmente ma è scadente durante una chiamata, il problema riguarda l’intero sistema anziché il microfono, e la sostituzione del microfono avrebbe costato un’unità e una settimana per nulla.
Dove il test in loopback va storto e cosa sta testando in realtà
Un test in loopback non è un test sbagliato; è un test di un sistema diverso. La riproduzione attraverso lo stesso dispositivo verifica il percorso audio nelle condizioni più pulite possibili: nessun codec, nessuna perdita di pacchetti, nessun jitter, nessun passaggio di rete e nessuna elaborazione dipendente dalla rete.
Proprio questa pulizia è il motivo per cui non può risolvere la domanda che si pone l’acquirente. Il problema che conta in questa categoria si manifesta su un percorso di rete, dove il codec applica filtri propri, dove un pacchetto viene perso e ritrasmesso e dove è attiva qualsiasi elaborazione che si attiva soltanto durante una chiamata. Un risultato in loopback conferma che la capsula del microfono, il percorso analogico e la catena di riproduzione locale funzionano. Non dice nulla sulla intelligibilità di una chiamata, che è l’unica domanda che si pongono davvero tutti coloro che acquistano un prodotto abilitato alle chiamate.
Vale la pena enunciare chiaramente la versione pratica: una chiamata di due minuti su una rete reale, a distanza conversazionale, nell’ambiente per cui il prodotto è venduto, registrata a entrambe le estremità se possibile. Costa due minuti ed è il test che ha sostituito ogni altro test in questa categoria più spesso di qualsiasi altra singola procedura.
Il secondo motivo per cui il loopback può trarre in inganno è più sottile. Poiché le condizioni sono pulite, il test in loopback viene superato più facilmente da prodotti solo marginalmente efficaci sul campo, selecting in questo modo il fornitore sbagliato: premia un’unità con un percorso locale ben realizzato e ignora il prodotto che si comporta bene sotto carico. Due fornitori possono superare entrambi il test in loopback e differire completamente durante una chiamata reale; il confronto in loopback tra loro non dice nulla.
Errore quattro: non registrare mai il silenzio. Trenta secondi di silenzio sul tavolo rivelano gate e pumping dovuti a una ridzione del rumore troppo aggressiva, il tratto distintivo di una catena di elaborazione che esagera. È più percepibile in condizioni silenziose, in un ufficio tranquillo o in un’auto di notte, che sono proprio i luoghi in cui nessuno effettua i test.
Questa è una modalità di guasto che non puoi sentire in un ambiente rumoroso, ma i tuoi clienti la sentiranno ogni volta che si toglieranno gli occhiali per rispondere a una chiamata in una stanza silenziosa. È anche il più economico dei sei problemi da individuare, perché costa trenta secondi e un registratore.
I trenta secondi di silenzio che rivelano più di un’ora di rumore
Il motivo per cui vale la pena registrare il silenzio è che il rumore maschera tutto, e il mascheramento è proprio ciò per cui una catena di riduzione del rumore è stata progettata. In un ambiente rumoroso, la catena sta facendo esattamente ciò per cui è stata progettata, quindi il test non può distinguere una buona catena da una cattiva. Nel silenzio, la catena non ha nulla su cui agire e qualunque cosa faccia in assenza di una sorgente diventa percettibile.
Ci sono tre informazioni che una registrazione del silenzio fornisce e nessun altro test offre. Mostra se il guadagno viene aumentato in assenza di voce, cioè nell’ambito da cui proviene un artefatto di pompaggio. Mostra se rimane un soffio di fondo, ovvero ciò che un noise gate mal regolato produce quando si chiude troppo. E mostra se la catena cambia stato in modo udibile, che è la differenza tra una catena di elaborazione aggressiva in modo controllato e una aggressiva in modo imprevedibile.
Il protocollo è semplice: posizionare l’unità su un tavolo in una stanza silenziosa, registrare trenta secondi, ascoltare con le cuffie anziché con gli altoparlanti e ripetere con l’unità indossata. Due registrazioni, un minuto: è il minuto più produttivo dell’intero programma di test dei microfoni.
Errori cinque e sei: considerare l’assenza di dati come garanzia di sicurezza
Errore cinque: considerare i dati non pubblicati come evidenza di assenza di rischi. Il nostro catalogo non pubblica nulla sui microfoni, e un acquirente che conclude «nessun dato, quindi nessun problema» sta facendo un’inferenza che i dati non supportano.
La riduzione del rumore del vento è il caso specifico. Un microfono montato sull’asta si trova direttamente nel flusso d’aria, e il rumore del vento è a bassa frequenza, l’intervallo peggiore in cui operano i filtri di base. Il software lo riduce; non può eliminarlo, perché l’informazione acustica è già contaminata prima di raggiungere il microfono.
Se il prodotto sarà utilizzato all’aperto, testarlo facendo soffiare aria sulla parte anteriore degli occhiali. È un test di ammissione anziché di perfezionamento, ed è l’unico test di questa categoria che una specifica tecnica priva di dati non può mai sostituire.
Errore sei: saltare il campione di riferimento. Conservare un’unità approvata, registrare il riferimento di base e confrontare ogni consegna successiva con esso.
Le prestazioni del microfono variano tra lotti di produzione più spesso di quanto suggeriscano le specifiche tecniche, di solito perché un fornitore di componenti ha cambiato prodotto e nessuno nel progetto se ne è accorto. Senza un riferimento conservato non è possibile rilevare le variazioni, e il canale di assistenza le scopre tramite i reclami.
Il vero valore di un’unità conservata
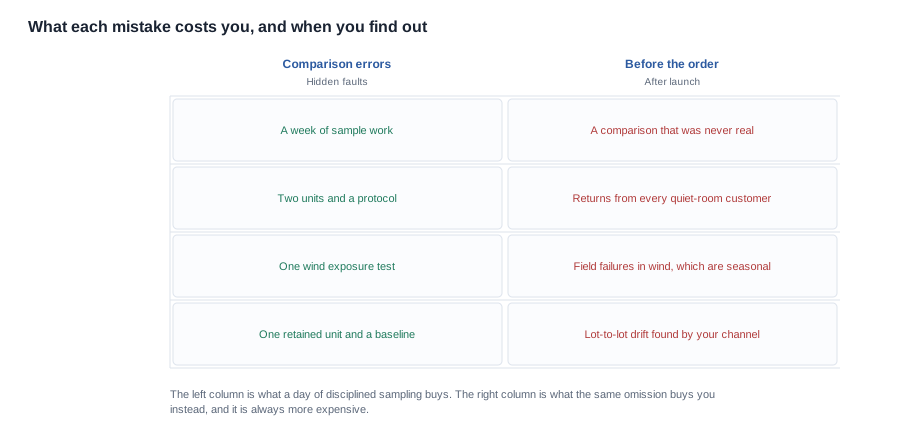
Il campione di riferimento è l’assicurazione più economica di questa categoria e quella che più spesso viene rifiutata, di solito perché l’unità conservata è considerata un valore perso: un’unità spedita, quindi che ha già comportato una spesa.
Vale la pena calcolarne correttamente il costo. Un’unità, conservata. A fronte: una registrazione di riferimento del test scripted in un ambiente definito, una fotografia della finitura e dell’asta e il riferimento di configurazione. Questo è l’intero asset e costa un’unità e mezza giornata.
A fronte di questo, si consideri il guasto che previene. Le variazioni tra loti sono invisibili al cliente finché non diventano udibili e, quando lo diventano, arrivano sotto forma di un gruppo di reclami improvvisi in un unico canale, senza alcun modo per identificare il lotto responsabile. Un riferimento conservato trasforma l’indagine in un confronto. Cambia anche il dialogo con il fornitore: anziché descrivere un reclamo, è possibile inviare la registrazione del lotto buono e quella del lotto difettoso, il che rende la conversazione molto più breve, di solito anche in termini di tempo.
La condizione da soddisfare prima di ordinare i microfoni
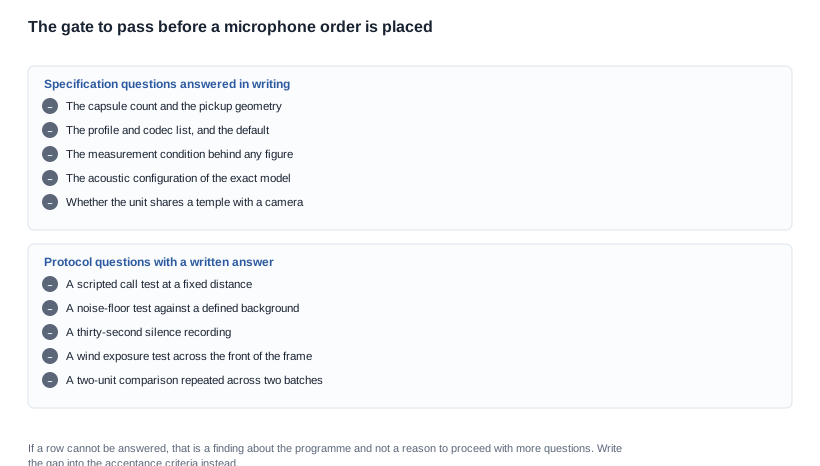
Se non è possibile rispondere a una voce di questa checklist, si tratta di una scoperta riguardante il programma, non di un motivo per proseguire con ulteriori domande. Inserire invece la lacuna nei criteri di accettazione. Una voce a cui si risponde «non pubblicato» allegando una misurazione del campione è chiusa; una voce a cui si risponde «non pubblicato» e poi si ignora è il modo in cui si verificano i sei errori descritti in questo articolo.
Due voci di questa checklist vanno messe in evidenza. Il numero delle capsule e la geometria di raccolta è la voce che determina se una funzione dedicata alla riduzione del rumore abbia un significato concreto, ed è una voce a cui può rispondere qualsiasi fornitore che abbia esaminato il proprio design. Il confronto tra due unità ripetuto su due lotti è la voce che fornisce una risposta alla domanda sulla coerenza ed è l’unico modo per rilevare le variazioni che il campione di riferimento misurerà in seguito.
Come scegliere tra due fornitori quando le prove sono discordi
La maggior parte delle liste di fornitori selezionati in questa categoria non si conclude con un verdetto netto e la tentazione è ricorrere al prezzo unitario. Esiste un modo migliore per arrivare a una decisione.
Definire i tre criteri prima di esaminare i risultati. Non l’intera checklist, ma i tre criteri che contano per il vostro programma. Per un prodotto per chiamate venduto per uso interno, probabilmente sono il risultato della chiamata scripted, la registrazione del silenzio e il numero delle capsule. Decidere quali tre criteri siano importanti prima che arrivino i dati è ciò che impedisce a un risultato forte su una voce di compensare un risultato debole su un’altra.
Pondera ogni criterio in base al costo di un errore. Un criterio il cui mancato rischio comporta un problema di copertura vale meno di uno il cui mancato rischio genera una contestazione per difetto. Chiediti per ogni criterio: se questo prendesse una direzione sbagliata, quanto costerebbe? La risposta determina il peso, e la pesatura rende espliciti i compromessi.
Tratta le righe mancanti come prove, non come un pareggio neutro. Un fornitore che ha risposto a tutte le righe è un fornitore con cui puoi stipulare un contratto. Un fornitore che ha risposto a tre su cinque presenta due incognite, e queste non sono simmetriche tra i fornitori: sono il motivo per cui il programma è rischioso.
Usa i segnali d'allarme per decidere tra chi è pari, non per escludere. Se due fornitori ottengono lo stesso punteggio sui tuoi tre criteri, i criteri di spareggio sono i segnali d'allarme: un peso indicato come intervallo, un certificato a livello di famiglia, un campione che arriva con un'asta diversa da quella richiesta. Ciascuno di questi elementi ti dice cosa accadrà quando qualcosa andrà storto in seguito.
Negozia in base al costo totale dell'incertezza, non al prezzo unitario. Il prezzo unitario di un programma per microfoni è un valore molto piccolo rispetto a una singola sostituzione, a un annuncio rifiutato o a un canale che smette di riassortire.
Svolgi la due diligence prima di ordinare, non dopo la prima lamentela. La checklist costa meno dell'accumulo dei resi, e la shortlist è il luogo giusto in cui investire. Queste sono le insidie da evitare in questa categoria, tutte evitabili in questa fase al costo di pochi giorni.
L'ordine dei controlli e perché conta
I controlli sono elencati in due blocchi perché sono diversi per natura, e la sequenza tra them mantiene economico il programma.
Il primo blocco riceve risposte scritte e richiede alcuni giorni. Se una riga di questo blocco non può essere compilata, il programma non è pronto per un lotto di campioni, perché il campione servirebbe a misurare un prodotto di cui non comprendi la progettazione. Un fornitore che risponde "abbiamo una riduzione avanzata del rumore" a una richiesta sul numero e sulla geometria delle capsule ti sta comunicando che il programma di campionamento dovrà svolgere il lavoro di una revisione della progettazione.
Il secondo blocco riceve risposte basate su unità e richiede una settimana. La registrazione in assenza di segnale viene prima perché è la più economica e perché un errore in questo punto invalida tutti gli altri risultati: se la catena di elaborazione genera pumping, ogni confronto scriptato successivo sarà contaminato dal pumping. Poi viene l'esposizione al vento, perché è l'unico test che nessun documento può sostituire. Quindi la chiamata scriptata su una rete reale, perché costituisce la conferma end-to-end. Infine, il confronto tra due unità di due lotti diversi, perché è quello che richiede più unità e quello che si preferirebbe non dover ripetere.
Un programma che segue questo ordine investe il proprio budget nei guasti più difficili da rilevare in seguito, e lo fa prima dell'ordine anziché dopo il lancio.
Un esempio pratico per un brand che ne ha colti tre insieme
Quanto segue è ipotetico e mostra l'ordine degli errori, non un incarico reale svolto da noi.
Supponiamo un brand che lancia una linea di occhiali abilitati alle chiamate e, dopo tre mesi, riceve da un singolo canale una serie di lamentele: clienti che segnalano che l'interlocutore non riesce a sentirli in auto. Il brand dispone di una scheda tecnica del prodotto, di un primo articolo approvato e di un verbale di prova che mostra il corretto funzionamento delle chiamate sul banco.
Passo uno: verifica se la lamentela corrisponde a un'aspettativa pubblicata. L'annuncio non dice nulla sull'uso in vehicle e la promessa del prodotto riguarda le chiamate in ambienti interni. Questo non rende infondate le lamentele, ma sposta la domanda da "perché il prodotto non funziona" a "cosa non ha dichiarato il testo".
Passo due: esegue il test in assenza di segnale su un'unità del lotto del canale interessato. La registrazione mostra del gain pumping in condizioni di silenzio: udibile, regolare e costante. Il problema punta alla catena di riduzione del rumore anziché alla capsula ed è un rilievo che un test di loopback non avrebbe mai prodotto, perché si verifica in assenza di qualsiasi segnale.
Passo tre: testa una seconda unità proveniente da un lotto diverso. Il comportamento è identico, quindi non si tratta di derive del lotto e il campione di riferimento non would've rilevato il problema. È un comportamento del prodotto.
Passo quattro: esegue il test al vento. L'aria davanti alla montatura produce un livello di degradazione coerente con le lamentele. Il meccanismo è ormai chiaro: una capsula a orecchio aperto montata nell'asta, in movimento d'aria, con una catena di elaborazione tarata per ambienti interni.
Passo cinque: cambia il rimedio, non il prodotto. I pezzi non sono difettosi. Il rimedio consiste in uno script di supporto che spiega il caso del veicolo, in una proposta ridotta all'interno dell'inserzione e in una nota al fornitore per verificare se il profilo di elaborazione possa essere regolato. Nessun pezzo viene sostituito e il tasso di resi diminuisce perché ora aspettativa e prodotto corrispondono.
Passo sei: aggiunge le righe mancanti al proprio controllo. Registrazione del silenzio, esposizione al vento, due pezzi provenienti da due lotti, quantità e geometria delle capsule. Quattro righe, tutte da svolgere in meno di un giorno e tutte utili a individuare il problema prima del lancio.
Il brand ha impiegato un giorno per la diagnosi e ha evitato un programma di sostituzione. Questo è l'intero ritorno di un rigoroso programma di test dei microfoni, disponibile per chiunque decida di adottarlo.
Cosa faremo e cosa non faremo con i vostri campioni
Detto chiaramente: l'unico dato sui microfoni che vale la pena acquistare è quello che avete prodotto sui vostri pezzi, seguendo un protocollo prestabilito. Non pubblicheremo una specifica del microfono che non possediamo e non citeremo un miglioramento che non abbiamo misurato.
Se inviate dei campioni, eseguiremo lo stesso protocollo insieme a voi e vi riporteremo ciò che sentiamo, inclusi i casi in cui il risultato è peggiore di quanto vi aspettavate. Quest'ultima parte conta più di quanto sembri: un fornitore che conferma soltanto ciò che speravate non sta fornendo una misurazione e non potete costruirci sopra un criterio di accettazione.
Consultate il controllo del rumore e la captazione del microfono per il trattamento di base e come testare prima dell'ordine per il protocollo. Le righe sulla configurazione pubblicata si trovano nelle specifiche chiave sulla qualità del microfono, mentre i controlli lato fornitore sono disponibili nella verifica del fornitore del microfono.
Se il problema è un difetto o un limite descritto
Inviateci un campione e indicateci l'ambiente in cui il prodotto viene venduto: eseguiremo il protocollo insieme a voi e vi riporteremo ciò che sentiamo, inclusi i casi in cui la risposta è un limite anziché un difetto. Se il vostro programma è già stato avviato e la coda dei reclami sta crescendo, inviate invece tre pezzi non conformi e uno funzionante: vi diremo quale causa corrisponde al pattern.
Letture correlate
- controllo del rumore e captazione del microfono
- checklist per l'acquisto dei microfoni
- domande e risposte sulla qualità del microfono
Inviateci dei campioni: eseguiremo lo stesso protocollo e vi riporteremo ciò che sentiamo.


