
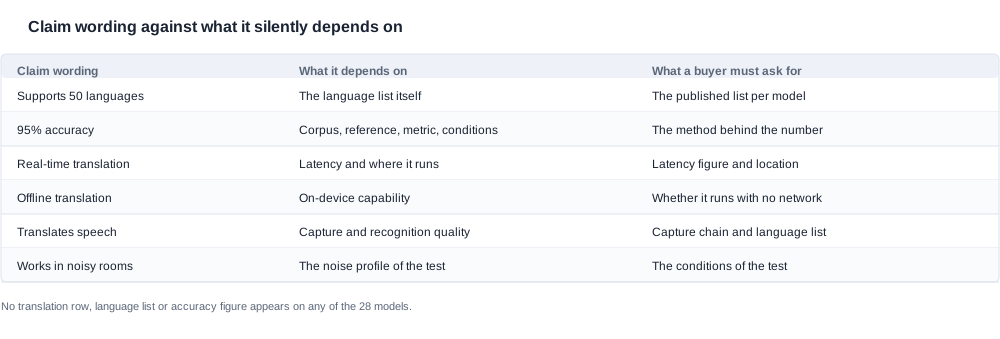
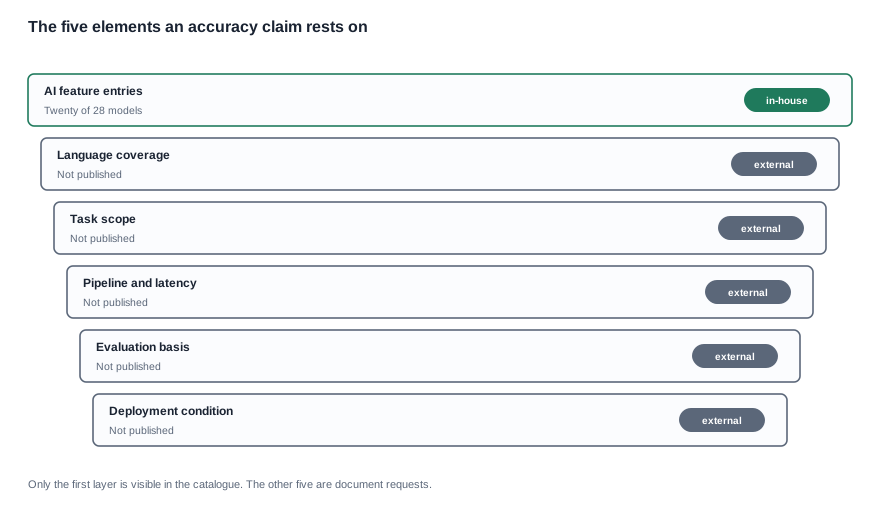
"Is de vertaling nauwkeurig" kan niet met een percentage worden beantwoord, en de reden is niet dat het percentage niet beschikbaar is, maar dat het woord nauwkeurig op zichzelf geen meetbare grootheid benoemt. Het verbergt minstens vijf afzonderlijke vragen: welke talen, in welke richting, via welke verwerkingsketen, beoordeeld aan de hand van welke referentie en onder welke omstandigheden. Twee producten kunnen allebei nauwkeurig worden genoemd en volledig verschillende producten zijn, en het verschil tussen beide zit in die vijf antwoorden en niet in één getal. De catalogus publiceert over geen van de vijf iets, en dat is het centrale feit van dit artikel — maar de catalogus publiceert wel iets dat er indirect bij hoort en dat regelmatig ten onrechte voor een vertaalspecificatie wordt aangezien; het nuttige deel is om die twee van elkaar te scheiden.
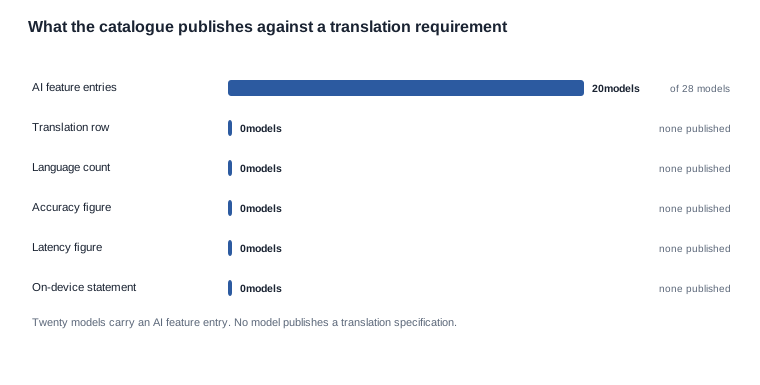
Dat indirecte feit is het aantal vermeldingen van AI-functies. Twintig van de achtentwintig modellen in deze reeks bevatten een vermelding van een AI-functie, en de aanwezigheid van een AI-vermelding vertelt een koper dat het model in de AI-categorie van de catalogus is ingedeeld. Het vertelt een koper niet welke talen het model ondersteunt, of het spraak of tekst verwerkt, of het op het apparaat of via een netwerk draait, hoe lang het duurt of hoe goed het werkt. Niets in de catalogus koppelt een AI-vermelding aan een vertaalrij, en geen enkel model in de reeks publiceert een vertaalrij.
is de vertaling nauwkeurig: wat de catalogus publiceert en wat niet
De catalogustekst bevat voor geen enkel model een vertaalspecificatie. Er is geen talenlijst en geen aantal talen, geen verklaring of de modellen spraak, tekst of beide verwerken, geen herkenningsmodel, geen vertaalmodel, geen indicatie of de verwerking op het apparaat of op afstand plaatsvindt, geen latentiecijfer, geen nauwkeurigheidspercentage, geen benchmarknaam, geen evaluatiecorpus en geen referentieset. De pagina's met een AI-vermelding plaatsen deze naast de standaardrijen — een cel, een laadlimiet, een runtimecategorie, een laadmethode en op sommige pagina's een Bluetooth-versie — en bevatten niets waarmee een koper een vertaalclaim kan beoordelen.
Twee details in deze reeks maken het de moeite waard om dit uit te leggen in plaats van het bij een omissie te laten. Ten eerste zijn het aantal vermeldingen en de werkelijke functionaliteit wezenlijk verschillende dingen. Een koper die een catalogus leest waarin staat dat twintig modellen AI-functies hebben, leest een uitspraak over de organisatie van de reeks, niet over wat die modellen kunnen doen. Ten tweede is het ontbreken van een vertaalrij in deze categorie niet ongebruikelijk — een productpagina voor audio of camera publiceert hardwaregegevens, terwijl vertaling doorgaans in de software sectie wordt gedocumenteerd in plaats van op de productpagina — en juist daarom moet een koper erom vragen in plaats van aan te nemen dat de leverancier er geen kennis van heeft.
Er is een derde punt over wat de reeks wél publiceert, en dat hangt rechtstreeks samen met de manier waarop een vertaalprogramma moet worden gespecificeerd. De catalogus publiceert voor de acht audiomodellen een Bluetooth-versie — 5.3 bij de K01 en de K02, en 5.4 bij de D12 en de YK12, de D11 en de G07, en de LC-105-1 en de LC-105-2 — en voor de elf cameramodellen geen enkele. Voor alle achtentwintig publiceert hij een cel, een laadlimiet en een runtimecategorie. Voor de elf cameramodellen publiceert hij een resolutieklasse en voor de V06 en de S7 een beschermingsmarkering. Geen van deze rijen zegt iets over een vertaalfunctionaliteit, en geen ervan is een alternatief daarvoor.
Waarom een vermelding van een AI-functie geen vertaalspecificatie is
Het aantal vermeldingen van AI-functies is het meest geciteerde structurele feit over deze reeks en het wordt het vaakst te veel geïnterpreteerd. Twintig van de achtentwintig modellen bevatten een vermelding van een AI-functie. Dat getal beschrijft een catalogusindeling: de reeks is verdeeld tussen vermeldingen met een regel voor AI-functies en vermeldingen zonder die regel, en de laatste groep omvat de drie kindermodellen en de drie vermeldingen zonder artikelnummer. Het is een uitspraak over de positionering van de producten en wordt gepubliceerd zonder beschrijving van wat de functie doet.
Er worden routinematig vier conclusies uit getrokken, en geen daarvan houdt stand. Dat een AI-functie een vertaalfunctie is, houdt niet stand, omdat geen enkel model een vertaaltabel of een talenlijst publiceert. Dat de twintig modellen één implementatie delen, houdt evenmin stand: de catalogus publiceert geen firmwarestructuur, geen gedeelde platformverklaring en geen gemeenschappelijke functielijst. Een koper moet daarom het gedrag van elk model als uniek beschouwen, tenzij de leverancier schriftelijk anders aangeeft. Dat de AI-functie een netwerk vereist, houdt niet stand, omdat de catalogus niets publiceert over waar de verwerking plaatsvindt. En dat de AI-functie de reden is om het product te kopen, houdt evenmin stand, omdat de catalogus geen basis biedt om een product met deze functie te vergelijken met een product zonder deze functie.
Operationeel betekent dit dat het aantal AI-functies een shortlist kan structureren, maar geen model kan kwalificeren. Een koper die vertaling in het product wil, heeft twee afzonderlijke werkstromen: een werkstroom voor functionaliteit, oftewel de onderstaande set van zes eisen, en een commerciële werkstroom, oftewel het apparaat, de connectiviteit en de bedrijfsvoering waarmee die functionaliteit wordt geleverd. De eerste is een documentaanvraag; de tweede is dezelfde afweging die bij elk verbonden product moet worden gemaakt. Als deze twee als één item worden behandeld, kan een programma uiteindelijk een functionaliteitsvraag beantwoord zien met een categorietelling, en kan een productvermelding uiteindelijk een functionaliteit claimen die niemand heeft getest.
Er is nog een gevolg voor het eisenstuk, en het is de moeite waard om dit voorin het dossier vast te leggen. Omdat de catalogus geen vertaalspecificatie en geen beschrijving van de functies per model publiceert, kan de eis niet worden geformuleerd als "de AI-functies van het model ondersteunen". Deze moet worden geformuleerd in de onderstaande vijf elementen, elk met een waarde en een bron. Daardoor wordt het eisenstuk langer, maar ook aanzienlijk nuttiger. Een op deze manier opgesteld eisenstuk heeft bovendien het voordeel dat een leverancier die de catalogus nooit heeft gezien het kan beantwoorden, en dat is precies de leverancier met wie een koper moet kunnen vergelijken.
De vijf elementen waarop een nauwkeurigheidsclaim berust
Een nauwkeurigheidscijfer kan niet op een pagina worden geciteerd, omdat het zonder de vijf onderliggende elementen betekenisloos is. Dit zijn die elementen, en elk daarvan is een vraag aan de leverancier, geen cijfer dat hoeft te worden opgezocht.
-
Taaldekking. Welke talen worden ondersteund, in welke richting en of de lijst symmetrisch is. De claim "ondersteunt vijftig talen" is zonder de lijst betekenisloos, omdat de lijst een koper vertelt of het taalpaar dat het programma nodig heeft erin staat. De catalogus publiceert voor geen enkel model een taalaantal of een talenlijst. Dit element heeft dus helemaal geen gepubliceerd antwoord, en van een leverancier die een aantal citeert moet de lijst worden gevraagd, samen met de richting waarin elke taal werkt.
-
De reikwijdte van de taak. Wat wordt vertaald en hoe het resultaat wordt geleverd: spraak naar spraak, spraak naar tekst, tekst naar spraak of tekst. Een spraak-naar-spraakpipeline en een spraak-naar-tekstpipeline verschillen met één schakel, en die schakel heeft een eigen nauwkeurigheidsgedrag, een eigen latentie en een eigen bestandsverwerking. Een programma dat de ene variant nodig heeft, kan niet worden beoordeeld op de prestaties van de andere. Een leverancier die zegt "het vertaalt", heeft nog niet aangegeven welke variant wordt aangeboden.
-
De pipeline zelf. Welke spraakherkennings- en vertaalsystemen worden gebruikt, waar de verwerking plaatsvindt en wat de latentie is. Dit is de plek waar de vraag over verwerking op het apparaat versus in het netwerk thuishoort, en dat is net zozeer een commerciële als een technische vraag. Een functie die van het netwerk afhankelijk is, gedraagt zich anders in een markt met slechte connectiviteit, en een koper die naar meerdere markten levert, kan geen enkele claim formuleren die in al die markten geldt.
-
De evaluatiebasis. Het corpus waartegen het systeem is getest, de referentie waarmee het is beoordeeld, de toegepaste metric, het aantal steekproeven en de omstandigheden waaronder deze zijn verzameld. Een nauwkeurigheidspercentage zonder deze vijf gegevens is een getal zonder betekenis, en de aanvraag is eenvoudig: elk percentage dat een leverancier aanbiedt, moet vergezeld gaan van het corpus en de metric. Een leverancier die deze niet kan verstrekken, houdt geen commercieel geheim achter, want een evaluatiecorpus is een beschrijving van een test en geen implementatiedetail.
-
De inzetomstandigheden. Accent, achtergrondgeluid, domeinvocabulaire, netwerkkwaliteit en de vaardigheid van de spreker. Dit is het element dat een demonstratie onderscheidt van een daadwerkelijke inzet, en het is het element dat inkoopteams het vaakst vergeten vast te leggen. De nauwkeurigheid van een moedertaalspreker die in een akoestisch behandelde ruimte een script voorleest, is een eigenschap van de test. Hetzelfde systeem zal in een drukke straat met domeinvocabulaire anders presteren op manieren die geen enkel gepubliceerd cijfer voorspelt.
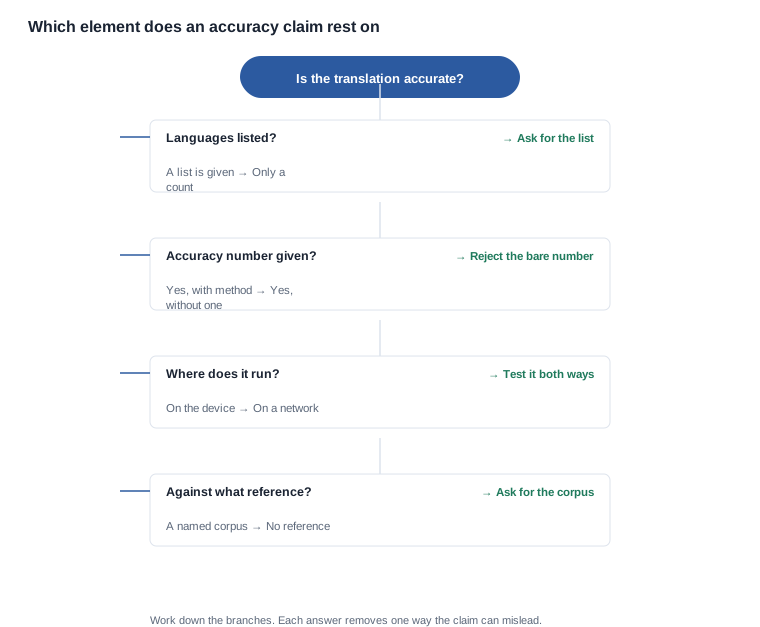
De vijf elementen in één overzicht:
| Element van een nauwkeurigheidsclaim | De vraag die een koper moet stellen | Gepubliceerde status |
|---|---|---|
| Taaldekking | Welke talen, in welke richting | Geen lijst en geen aantal |
| Reikwijdte van de taak | Spraak naar spraak, of spraak naar tekst | Geen verklaring in beide richtingen |
| Erkennings- en vertaalproces | Wat wordt waar uitgevoerd, en hoe lang duurt het | Niet beschreven |
| Evaluatiebasis | Welk corpus, welke referentie en welke meetwaarde | Geen cijfer en geen methode |
| Inzetomstandigheden | Welk geluidsniveau, welk accent en welke woordenschat | Niet beschreven |
De vijf elementen zijn ook de reden dat een vergelijking met concurrenten doorgaans een vergelijking van claims is, en niet van systemen. Wanneer twee productpagina's allebei nauwkeurigheid beloven en geen van beide aangeeft waarop dit gebaseerd is, levert de vergelijking niets op. Een koper die de marketingtekst als specificatie behandelt, zal het verschil pas in de praktijk ontdekken, en niet tijdens de evaluatie.
Zo vraagt u om een nauwkeurigheidsantwoord dat u kunt archiveren
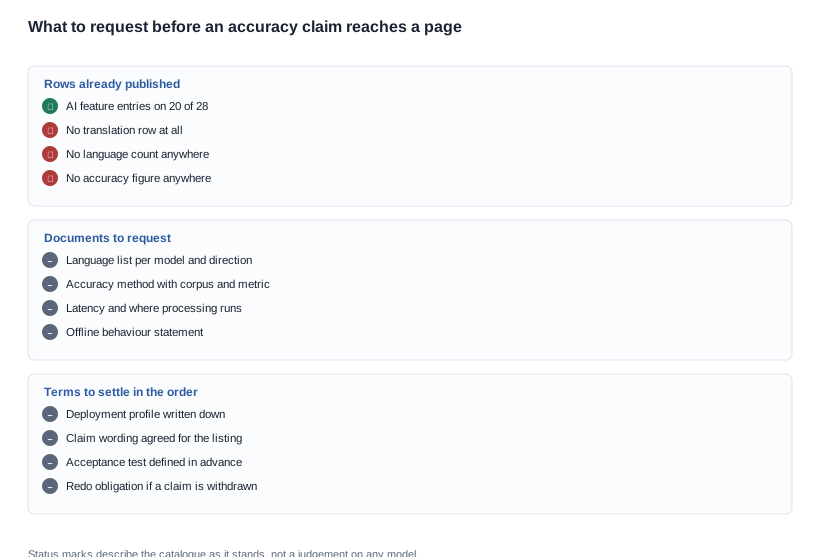
De set met vragen is kort en is voor elk geëvalueerd model dezelfde. Zes onderwerpen sluiten de vijf elementen af.
De talenlijst, per model, met richting. Dit is één document en sluit het eerste element volledig af.
Een verklaring van de reikwijdte van de taak, zodat spraak-naar-spraak en spraak-naar-tekst niet met elkaar worden vergeleken. Dit sluit het tweede element af en voorkomt de meest voorkomende denkfout bij vertaalvergelijkingen.
Een beschrijving van het verwerkingsproces, met vermelding van waar de verwerking plaatsvindt en wat de latentietijd is, waarbij de afhankelijkheid van het netwerk expliciet wordt gemaakt. Dit sluit het derde element af en is het onderwerp dat een koper met meerdere bestemmingen het meest nodig heeft, omdat het bepaalt of de functie in elk van die markten haalbaar is.
De evaluatiebasis, gekoppeld aan elk genoemd nauwkeurigheidscijfer. Als er geen cijfer wordt genoemd, vraagt u om een testprotocol en een meetwaarde die de koper accepteert. Dat is een sterkere positie dan een overgenomen getal, omdat deze vooraf is vastgelegd, vóórdat de steekproef binnenkomt.
Een inzetprofiel, met vermelding van de omstandigheden waaronder de functie naar verwachting werkt: geluidsniveau, accent, woordenschat en netwerk. Dit sluit het vijfde element af en is de bepaling die een functie omzet in een eis.
Een toezegging voor een hertest, met vermelding van wat er gebeurt als de functie in de omstandigheden van de koper niet presteert zoals beloofd. Dit is de commerciële voorwaarde die aan het vierde element is gekoppeld en zonder deze voorwaarde is de evaluatie advies in plaats van controle.
De kwaliteit van de antwoorden is zelf ook waard om te beoordelen, omdat de bovenstaande set met vragen sterk uiteenlopende resultaten oplevert, afhankelijk van wat u terugkrijgt. Het beste antwoord bestaat uit een talenlijst met richtingen, een verklaring van de reikwijdte van de taak, een beschrijving van het verwerkingsproces waarin staat waar de verwerking plaatsvindt, en een evaluatiebasis die aan elk genoemd cijfer is gekoppeld. Met dat antwoord kan een koper, vóórdat een steekproef binnenkomt, beslissen of de functie zelfs binnen de scope van het programma valt. Het gewone antwoord geeft de talenlijst en de reikwijdte van de taak en stopt daar. Daarmee zijn de twee elementen afgerond die een model het vaakst uitsluiten. Het slechte antwoord vermeldt een aantal talen en een percentage zonder verdere toelichting. Dat levert niets op en moet worden teruggestuurd met de specifieke vraag die is overgeslagen.
Een koper die een antwoord tweemaal moet terugsturen, moet vastleggen wat er ontbrak, want het ontbrekende onderwerp is meestal datgene wat de leverancier niet als onderdeel van het product beschouwt. Als u om een corpus vraagt voor een nauwkeurigheidscijfer, vraagt u in feite om een onderbouwing van de methode. Een leverancier die daar nooit om is gevraagd, heeft mogelijk geen corpus. Dat maakt het antwoord onacceptabel, maar betekent wel dat de nauwkeurigheidsclaim opnieuw moet worden geclassificeerd van specificatie naar bewering en dat de productvermelding dienovereenkomstig moet worden opgesteld. Vroeg herclassificeren is goedkoop. Na een lancering herclassificeren betekent intrekken.
Wat een niet-onderbouwde nauwkeurigheidsclaim een programma kost
Het zakelijke argument om dit goed aan te pakken verdient nader toelichting, omdat de kosten van een onjuiste nauwkeurigheidsclaim niet gelijk verdeeld zijn over een bedrijf. De directe kosten zijn vertrouwder: retourzendingen, supportcontacten en de reputatieschade van een openbaar gemaakte en later ingetrokken claim. Twee indirecte kosten zijn groter en worden minder vaak meegeteld.
De eerste is de kosten van een shortlist die opnieuw moest worden samengesteld. Als een model wordt geselecteerd omdat een nauwkeurigheidscijfer is geaccepteerd zonder onderbouwing en dat cijfer blijkt te verwijzen naar een test die de koper niet zou hebben uitgevoerd, moet de selectie worden heropend. Een shortlist heropenen op het moment dat de steekproeven al zijn besteld en geëvalueerd, is de duurste vorm van heropenen, omdat de evaluatiekosten dan al zijn betaald.
De tweede kostenpost is die van een listing die niet kan worden verdedigd. Channelpartners en marketplace-reviewers vragen om onderbouwing, en een claim zonder methode kan niet op verzoek worden onderbouwd. Het gevolg is meestal geen afwijzing, maar een downgrade — de claim wordt verwijderd, de listing wordt herschreven en het verkoopmateriaal waarin deze wordt genoemd, moet eveneens worden ingetrokken. Dat is een kostenpost die over elk reeds gelist product wordt verdeeld en die in de unit economics onzichtbaar blijft totdat deze zich voordoet.
Beide kostenposten worden vermeden door dezelfde handeling: vóór de voorbeeldronde bepalen welk bewijs een claim vereist. Dat is een totale-kostenbeslissing en geen technische beslissing. Daarom behoort de verzoekset van zes punten in de eisenbrief, en niet in een late e-mail aan een leverancier wiens evaluatie al in rekening is gebracht.
Twee van die zes punten zijn het waard om er even uit te halen. Het deploymentprofiel is het punt dat kopers het vaakst overslaan, en het overslaan ervan leidt tot de duurste foutmodus in deze categorie: een functie die presteert in een demo en faalt op de markt, waarbij de ontdekking plaatsvindt na de lancering in plaats van tijdens de evaluatie. De toezegging tot herherkening is het punt dat een leveranciersgesprek onderscheidt van een contract, omdat zonder een genoemde consequentie het evaluatieresultaat alleen adviserend is. Samen veranderen ze een vraag zonder antwoord in een bepaling met een antwoord.
Er is nog een belangrijk punt over de verhouding tussen vertaling en de rest van de catalogus. Een vertaalworkflow in een wearable hangt vrijwel altijd af van de opnameketen en van de bestandsverwerking — van de vraag of de microfoon de spraak oppakt, van het formaat waarin de opname wordt opgeslagen en van de manier waarop het bestand vervolgens wordt verplaatst en verwerkt. Noch de opnameketen noch de bestandsverwerking wordt gepubliceerd in dit assortiment: geen enkel model publiceert een microfoonregel, een sample rate, een bitdiepte, een bestandsformaat of een opslagcapaciteit. Een koper die vertaling als losse functie evalueert, moet deze dus ook als losse functie evalueren. Een koper die deze evalueert als onderdeel van een opnameworkflow moet erop bedacht zijn dat de twee helften van die workflow een aparte bewijspositie hebben.
is de vertaling nauwkeurig: wat moet in de bestelling staan
Het schriftelijke antwoord op deze vraag bestaat uit drie delen.
Wat de catalogus publiceert, is een AI-functie-entry voor twintig van de achtentwintig modellen, naast de standaardregels: cel, maximale laadvermogen, runtimeklasse, oplaadmethode en een Bluetooth-versie voor de acht audiomodellen. Wat niet wordt gepubliceerd, is enige vertaalregel, talenlijst, taalaantal, taakbereik, herkenning- of vertaalmodel, latentiecijfer, nauwkeurigheidscijfer, benchmark, corpus of referentieset voor een van de modellen in dit assortiment. We publiceren voor geen enkel model een vertaalspecificatie. Een koper die een nauwkeurigheidscijfer zonder de bijbehorende evaluatiebasis heeft gekregen, moet dit beschouwen als een marketingclaim totdat de basis wordt verstrekt.
U moet de hierboven genoemde verzoekset van zes punten opvragen en het deploymentprofiel en de toezegging tot herherkening in de bestelling opnemen, in plaats van ze in de correspondentie te laten staan.
De bestelling moet daarnaast nog één andere zin bevatten die zelden wordt opgenomen en waarvan kopers later dankbaar zullen zijn: wat er met de listing gebeurt als de functie wordt ingetrokken, uitgesteld of niet aan de acceptatietest voldoet. In een categorie waarin een claim berust op softwaregedrag en niet op een fysieke specificatie, is het intrekkingspad een commercieel risico en geen technisch risico. De formulering ervan vooraf afspreken is veel goedkoper dan deze onderhandelen nadat een functie is geadverteerd en vervolgens is gewijzigd. De formulering is niet ingewikkeld. Het gaat erom te vermelden of de pagina wordt gewijzigd, of het materiaal wordt gewijzigd en binnen welke termijn.
De houding die de moeite waard is, is dat de vraag nooit echt om een getal ging. Nauwkeurigheid is een verhouding tussen een systeem en een omstandigheid, en die omstandigheid is wat een koper beheerst en wat een leverancier niet kan zien. Een koper die de omstandigheid specificeert, krijgt een antwoord dat kan worden verdedigd. Een koper die om een percentage vraagt, krijgt een cijfer dat bij iemand anders’ test hoort. De pagina over AI-functies behandelt de categorie, AI-functies kiezen behandelt de selectiekant, AI-functies meten behandelt de evaluatievraag, AI-functies vergelijken behandelt de vergelijkingsvraag en heeft de AI-functie internet nodig behandelt de netwerkafhankelijkheid in detail.
Gerelateerd leeswerk
- Selectie op AI-mogelijkheden: hoe je slimme brillen kiest op AI-functies.
- Beoordeling van een AI-claim: hoe je AI-functies van slimme brillen meet.
- Vergelijking van twee AI-implementaties: hoe je AI-functies van slimme brillen vergelijkt.
- De netwerkafhankelijkheid die het antwoord verandert: heeft de AI-functie internet nodig.
- Dezelfde vragen beantwoord voor de camerafamilie: veelgestelde vragen over AI-camerabrillen.
Geef de voorwaarde aan en het antwoord wordt controleerbaar; vraag om een percentage en het antwoord behoort tot iemand anders test.


