
Uno studio di caso su una funzionalità IA è quasi sempre inaccettabile per la pubblicazione, perché riporta un risultato senza le condizioni che lo hanno prodotto. Il modello di studio di caso sulle funzionalità AI degli smart glasses non è quindi realmente un modello per la pubblicazione, ma uno strumento per produrre prove su una capacità che non può essere definita in anticipo. Se avete letto il resto della nostra copertura sull’IA, saprete già che la nostra documentazione non pubblica cifre di accuratezza, copertura linguistica, latenza o dettagli dell’architettura per nessuno dei nostri 28 modelli: ciò significa che, da parte nostra, non esiste alcuno studio di questo tipo che possiate replicare.
È proprio questa assenza il motivo per cui il modello è importante. Nella maggior parte delle categorie, un acquirente può redigere una specifica e verificare il fornitore rispetto a essa. Nella categoria IA, invece, le domande sulle capacità — accuratezza, copertura linguistica, comportamento offline, latenza — non possono essere risolte dalla documentazione, perché in questo settore non c’è nulla da consultare e, in linea di massima, lo stesso vale per la maggior parte dei fornitori. Il campione è quindi lo strumento di misurazione. È l’unico dispositivo a vostra disposizione che può produrre un numero specifico per il vostro prodotto.
Funzionalità AI degli smart glasses: perché gli studi non possono essere pubblicati
Il problema strutturale
Uno studio di caso è la relazione di qualcosa che è accaduto, ed è utile soltanto se il lettore può individuare che cosa è accaduto a causa di quali condizioni. La maggior parte degli studi sulle funzionalità IA non supera questa verifica in uno di tre modi.
Mancano le condizioni. Lo studio riporta un «92% di accuratezza sulle richieste dei clienti» senza indicare il contenuto testato, la coppia linguistica, le condizioni di rete né la data. Quel numero non è una misurazione, ma una cifra priva del proprio riferimento, che né voi né chiunque altro può replicare.
Mancano gli errori. Lo studio riporta ciò che ha funzionato. Una relazione sui successi è una dimostrazione, mentre l’elenco degli errori è la parte che riveste valore ingegneristico. È anche la parte che indica all’acquirente se la funzionalità può sostenere l’onere di un’affermazione pubblicitaria.
Mancano i requisiti. Lo studio è stato condotto senza una dichiarazione scritta delle funzioni che la caratteristica doveva svolgere, Produce quindi dati, ma non una decisione. È l’errore più comune e anche il più costoso, perché l’acquirente finisce per confrontare i dati con un’aspettativa mai messa per iscritto e quindi impossibile da verificare.
Perché la documentazione non può sostituire lo studio
Le domande sulle capacità in questa categoria non vengono pubblicate. Non da noi e — da quanto ci riferiscono gli acquirenti — neppure dalla maggior parte dei fornitori. Non esiste un metodo di prova standard per l’accuratezza dell’IA su un dispositivo indossabile, né una condizione standard per misurare la latenza o una definizione standard del significato di «supporto offline».
In concreto, ciò significa che il campione è lo strumento di misurazione e che servono circa un giorno di lavoro per produrre qualcosa di difendibile. Un giorno è un costo reale rispetto a un calendario di lancio, ma è un costo molto contenuto rispetto all’alternativa di scoprire il comportamento dopo la pubblicazione dell’annuncio.
A cosa serve un modello
In questa categoria, un modello non è un formato documentale. È un protocollo ed esiste per fare sì che due condizioni siano soddisfatte contemporaneamente: che il risultato sia abbastanza specifico da consentire un’azione e che qualcun altro possa ripeterlo.
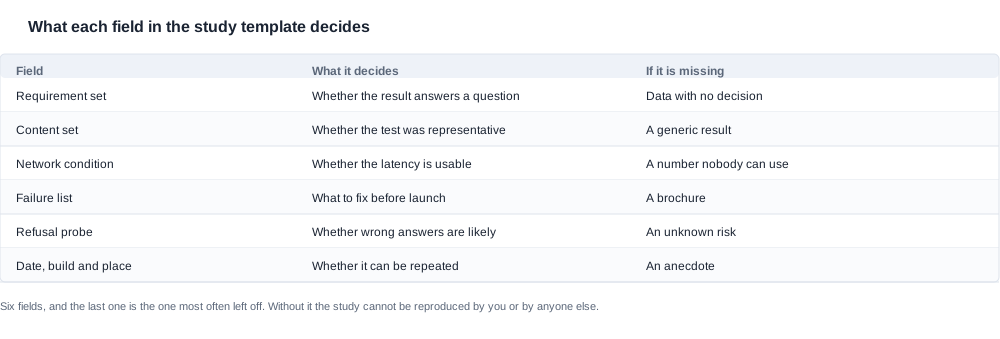
I sei campi seguenti sono il minimo necessario. Ognuno colma una specifica lacuna, e uno studio che ne ometta anche uno solo non dovrebbe essere diffuso come prova — non perché sia disonesto, ma perché non può supportare una decisione.
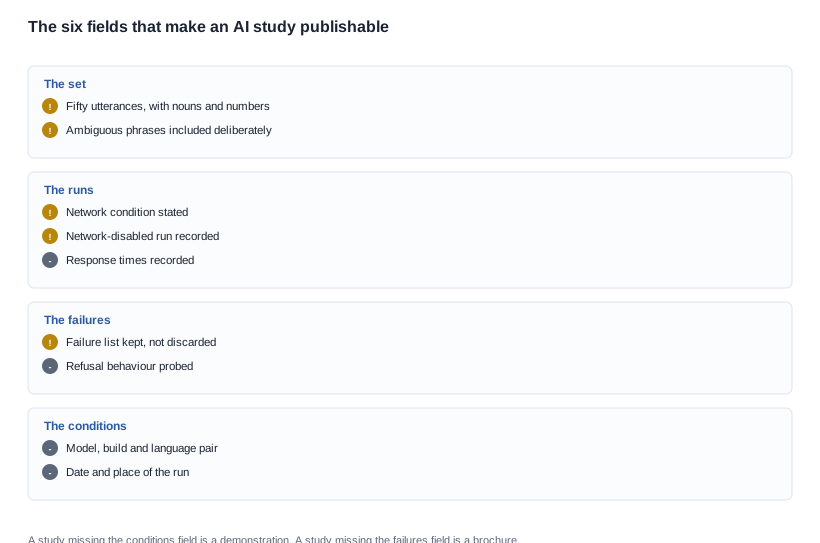
I sei campi che rendono replicabile uno studio
Primo campo: l’insieme dei requisiti
Una dichiarazione scritta delle funzioni che la caratteristica deve svolgere, redatta prima del primo prompt e datata. Non un elenco di comportamenti desiderabili, ma una soglia per ciascuna funzione, formulata nei termini che il canale considera davvero importanti.
Per una funzionalità di traduzione in un canale retail, l’insieme dei requisiti potrebbe essere: la coppia linguistica deve essere gestita per le lingue elencate; una richiesta parlata deve essere trascritta con accuratezza sufficiente per consentire un’azione; la risposta deve arrivare entro un tempo prestabilito su una connessione prestabilita; e, quando il sistema nutre dubbi, deve indicarlo anziché formulare una risposta fluente.
L’insieme dei requisiti trasforma lo studio da una descrizione in una decisione ed è il campo più spesso omesso, perché sembra burocrazia finché non arriva il momento di stabilire se un risultato sia superato o meno.
Secondo campo: l’insieme dei contenuti
Cinquanta frasi simili a quelle che il cliente dirà davvero. Includere nomi propri, numeri, unità, codici di prodotto, nomi che potrebbero riferirsi a due cose diverse e formule deliberatamente ambigue.
Un set di test generico produce un risultato generico che non dice nulla sul tuo prodotto. Trenta frasi facili e venti difficili, con quelle difficili scritte in modo da essere davvero difficili, costituiscono un set migliore di uno formato da fifty frasi che supererebbero anche uno script dimostrativo.
Il set deve essere scritto da qualcuno che conosce il canale, non da chiunque abbia più tempo a disposizione. Un responsabile dell’assistenza che ha letto mille ticket per la tua categoria scriverà un set di contenuti migliore di un ingegnere che lavora da un elenco di funzionalità, perché sa quali frasi compaiono davvero e quali vengono fraintese.
Campo tre: la condizione di rete
Qual era lo stato della connessione durante l’esecuzione di ogni test. È più utile indicarlo così: la condizione normale per il tuo mercato più difficile, non quella nella sala dimostrativa del fornitore.
Se il tuo canale comprende mercati con connettività irregolare, allora la condizione «normale» per lo studio sarà una connessione scarsa e il risultato ti dirà se la funzionalità è utilizzabile oppure soltanto disponibile. Questo è il campo più spesso lasciato implicito ed è quello che influenza maggiormente la conclusione.
Campo quattro: l’esecuzione senza rete
Il campo più spesso omesso e quello che determina dove il prodotto può essere utilizzato. Disattiva la rete ed elenca tutto ciò che continua a funzionare: acquisizione, chiamate, riproduzione, assistente, impostazioni.
Se il tuo cliente utilizzerà il prodotto in un magazzino, in cantina o all’estero con una connessione scarsa, quella sarà la condizione operativa, non un caso limite. L’esecuzione senza rete è ciò che ti dice se la funzionalità AI può essere una dipendenza o soltanto un valore aggiunto e, di conseguenza, se puoi presentarla sulla confezione come motivo per acquistare il prodotto.
Campo cinque: l’elenco degli errori
Registra gli errori in modo specifico, indicando l’input, l’output e il motivo del fallimento. Non un conteggio, ma un elenco.
Un conteggio indica una percentuale e una percentuale senza gli input che la sottendono non è sufficiente per agire. L’elenco ti dice quali input sono suscettibili di causare problemi ed è da esso che si ricavano lo script di assistenza, la sintesi per la formazione e le avvertenze per l’inserimento dell’annuncio.
Campo sei: condizioni, build e luogo
Il modello, la build del firmware, la data, il luogo, la coppia linguistica, l’identificatore dell’unità e lo strumento utilizzato per la misurazione del tempo. È il campo più spesso tralasciato e quello che distingue uno studio da un aneddoto.
Senza questi dati, non puoi riprodurre un risultato, il che significa che nessuno può riprodurlo, perché le unità testate sono sparite e il firmware è stato aggiornato nel frattempo.
Come creare il set di contenuti che testa davvero la funzionalità
Un metodo che produce risultati confrontabili
Il set di contenuti è la parte del modello in cui risiede la maggior parte delle valutazioni ed è importante definire con precisione come crearne uno che possa essere utilizzato da un altro ingegnere.
Parti da input reali, non da input plausibili. La fonte migliore è costituita dai ticket di assistenza, dalle trascrizioni delle chiamate, dai registri delle ricerche o dalle note vocali che il tuo canale riceve già. Preleva un campione, quindi elimina i dati personali. Se il canale è nuovo, la seconda fonte migliore sono le dieci domande che un venditore riceve più spesso, formulate con le parole del cliente anziché con quelle del prodotto.
Introduci la difficoltà in modo deliberato. Dividi le fifty richieste in tre livelli e annota il numero di ciascuno: le richieste che una dimostrazione supererebbe, quelle che contengono un nome proprio, un numero o un’unità di misura e quelle genuinamente ambigue, come un nome che potrebbe riferirsi a due persone, un numero privo di contesto o una frase con due interpretazioni. Il terzo livello è quello in cui si trova il valore ingegneristico ed è anche quello in cui emerge il rischio di una risposta fluente ma errata.
Includi deliberatamente i casi negativi. Ogni set deve contenere prompt che dovrebbero essere rifiutati o per i quali non esiste una risposta corretta. Un sistema che restituisce una risposta sicura e fluente ma priva di senso è più dannoso di uno che non restituisce nulla, e ciò è invisibile in una dimostrazione, poiché le dimostrazioni sono composte da prompt che funzionano.
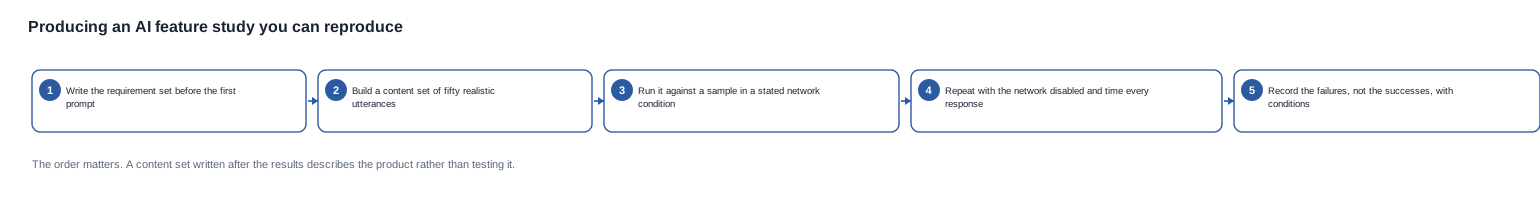
Scrivi il set prima che arrivi il campione, o almeno prima di averlo visto funzionare. Un set scritto dopo i risultati descrive il prodotto anziché testarlo, e la differenza non è individuabile dall’output: lo è soltanto se si sa che cosa si intendeva includere.
Esecuzione e registrazione di ciò che accade
Esegui ogni prompt su un campione, in una condizione di rete dichiarata, e registra quattro elementi per ogni prompt: ciò che è stato detto, ciò che è stato restituito, quanto tempo è occorso e se la risposta era corretta, incompleta, errata oppure rifiutata correttamente.
Misura ogni risposta rispetto a una soglia fissa, anziché registrare soltanto il valore grezzo. Un dato sulla latenza grezza senza una soglia associata non dice nulla sull'utilizzabilità della funzionalità; una soglia la trasforma in un esito positivo o negativo, e tale esito può confluire in una specifica.
Ripeti la prova con la rete disattivata sullo stesso insieme di elementi e registra che cosa continua a rispondere. Se un prompt del primo insieme fallisce con la rete disattivata, rientra nell'insieme delle limitazioni della tua scheda prodotto.
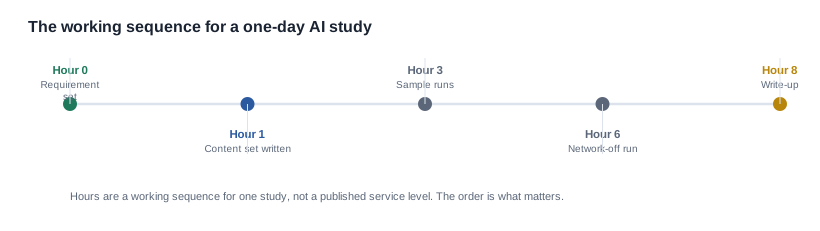
La sequenza operativa seguente rientra comodamente in una giornata per un singolo prodotto e una singola funzionalità ed è volutamente ordinata in modo che le prove più difficili si svolgano mentre il team è ancora concentrato.
Tre destinatari, tre versioni dello stesso studio
Uno studio di solito deve servire tre lettori, mentre l'errore consiste nel scrivere un unico documento che tenta di soddisfare tutti e tre. Hanno bisogni diversi e richiedono livelli di dettaglio diversi.
Il team interno — prodotto, assistenza e marketing — necessita dell'elenco degli errori e dell'insieme delle limitazioni. Deve sapere quali input falliscono e che cosa fa la funzionalità in assenza di connessione, perché da queste informazioni si elaborano lo script di assistenza e la nota di formazione. Non ha bisogno dei tempi grezzi per ogni prompt, ma della soglia e dell'indicazione che è stata rispettata.
Il fornitore necessita dell'insieme dei requisiti, dell'insieme dei contenuti e dell'elenco degli errori in una forma sulla quale possa intervenire. Conviene inviare direttamente l'insieme dei contenuti, perché un fornitore che può consultare i prompt esatti è in grado di riprodurre la prova e spiegare gli errori, operazione più rapida rispetto al tentativo di descrivere Fifty utterances in un'email.
Il team che si interfaccia con i clienti — il canale, il personale dei punti vendita, il rivenditore — necessita di una sola pagina. Deve sapere che cosa fa bene la funzionalità, che cosa non è in grado di fare e che cosa dire quando un cliente chiede qualcosa che va oltre le sue capacità. Questa pagina è l'ultima da scrivere, perché deve essere veritiera e lo diventa soltanto quando sono noti gli errori.
Scriverli in quest'ordine evita inoltre che lo studio venga plasmato in funzione del destinatario marketing. Se la scheda prodotto viene scritta per prima, l'insieme dei contenuti tende a essere costruito sulle frasi che il copy promette già e lo studio conferma quindi il copy anziché testare il prodotto. Questo è il meccanismo di errore che l'intero modello mira a prevenire.
Mantenere utile lo studio dopo il lancio
Uno studio è generalmente più prezioso nei mesi successivi al lancio, quando arriva la prima ondata di richieste reali e diventano visibili le discrepanze tra l'insieme di prova e la realtà.
Due abitudini lo rendono possibile. Conservare insieme allo studio l'insieme dei contenuti e le condizioni, anziché conservare soltanto i risultati, in modo che una prova successiva sia confrontabile con la prima. E programmare una nuova esecuzione a intervalli definiti e in base a eventi scatenanti definiti — dopo un aggiornamento del firmware, dopo un cambio di fornitore e prima di qualsiasi campagna importante che genererà traffico insolito. Una funzionalità IA che è cambiata senza che tu ne sia stato informato dall'ultimo studio è una funzionalità la cui scheda prodotto potrebbe non essere più veritiera, e il costo di accorgersene tramite uno studio è di gran lunga inferiore a quello di scoprirlo tramite un reclamo.
Trasformare uno studio in una decisione anziché in un documento
Confronta il risultato con il tuo insieme di requisiti, non con un altro prodotto
Se hai definito che cosa la funzionalità deve fare prima di eseguire i test, ora hai una risposta su cui intervenire. Altrimenti, hai dati senza una domanda. Questa è l'intera ragione per cui esiste il primo campo, ed è importante ribadirla perché è il punto in cui la maggior parte degli studi va storta.
Confrontare il proprio risultato con quello di un altro fornitore è quasi sempre un errore in questa categoria, perché i due risultati sono stati prodotti in condizioni diverse, su insiemi di contenuti diversi e con soglie diverse. Finiresti per scegliere in base al numero anziché in base alle prove.
Il confronto efficace è su tre fronti: il tuo risultato rispetto al tuo insieme di requisiti, il tuo risultato rispetto allo stesso insieme di requisiti applicato agli altri fornitori e la differenza tra i risultati confrontata con il costo che essa comporterebbe. Il terzo passaggio è quello che gli acquirenti saltano, ed è quello che trasforma il risultato di una prova in una decisione di acquisto.
Redigi il documento in modo che qualcun altro possa ripetere la prova
Ciò significa includere l'insieme dei contenuti, le condizioni e il metodo, non la conclusione. Un risultato che un altro ingegnere non riesce a riprodurre è un'affermazione accompagnata da una tabella.
La relazione deve essere abbastanza breve da essere letta da un collega e sufficientemente completa da consentirgli di eseguirla. In pratica significa: l’insieme dei requisiti, l’insieme dei contenuti rappresentato dai cinquanta prompt effettivi, la tabella delle condizioni, la tabella dei risultati con l’elenco degli errori e una conclusione di un paragrafo che indichi quali requisiti sono stati soddisfatti e quali no.
Decidere il caso di degrado in base al risultato
Il test con la rete disattivata è quello che determina se la funzionalità può essere una dipendenza o soltanto un valore aggiunto. Se il degrado è accettabile, la funzionalità può essere utilizzata in sicurezza come elemento di marketing. Se il degrado significa che il prodotto non è più in grado di fare ciò per cui è stato acquistato, allora vanno modificati i testi oppure il prodotto, ed è meno costoso prendere questa decisione ora che dopo il lancio.
Dall’elenco degli errori emerge una seconda decisione: se la modalità di errore sia visibile. Un sistema che dice «Non l’ho colto» rientra nel copione dell’assistenza. Un sistema che risponde in modo sicuro e sbagliato è un problema di natura completamente diversa, ed è quello che non emergerà dal tuo set di test se il set è troppo accomodante.
La conseguenza commerciale dello studio
Uno studio completato modifica tre aspetti commerciali ed è opportuno utilizzarlo deliberatamente anziché lasciarlo in una cartella.
I criteri di accettazione dell’ordine. Le soglie misurate diventano i criteri dell’ordine di acquisto e un lotto che non li rispetta è un lotto che puoi rifiutare. Senza lo studio non hai nulla su cui basare il rifiuto.
La garanzia. Una garanzia formulata rispetto al criterio di errore emerso dal sesto campo è misurabile al momento della richiesta di intervento. Una garanzia formulata rispetto a una descrizione è una trattativa.
L’annuncio. L’elenco degli errori e il test con la rete disattivata determinano i tuoi testi. Una descrizione circoscritta, costruita su un risultato misurato, è difendibile; una descrizione ampia, costruita su una dimostrazione, non lo è.
Ciò che la nostra documentazione lascia aperto
La nostra documentazione fa riferimento a una funzionalità di assistente vocale AI per le piattaforme con fotocamera e descrive il supporto alla traduzione AI sul sito indipendente. Non pubblica alcun dato sull’accuratezza, alcun elenco delle lingue supportate, alcuna indicazione sulla latenza, sul comportamento offline, sul luogo di elaborazione, sulle condizioni degli abbonamenti o sulla giurisdizione dei dati.
Questo significa che non possiamo fornire una versione completa di questo modello per i nostri prodotti e preferiamo dirlo piuttosto che pubblicare uno studio del cuicannot descrivere le condizioni. Significa inoltre che, se esegui questo studio su uno dei nostri campioni, produrrai prove che nessun altro nella filiera potrà presentare, una posizione strange per un produttore, ma utile per un acquirente.
Possiamo offrire l’altra metà del lavoro. Inviaci uno studio che hai eseguito su uno dei nostri campioni e ti diremo quali risultati sono coerenti con i dati che abbiamo pubblicato e quali non lo sono. Un risultato in conflitto con la nostra documentazione è un’informazione che vale la pena conoscere, per entrambe le parti.
Per quanto riguarda ciò che il nostro catalogo include e non include: venti delle nostre 28 voci di modello sono designate come prodotti AI, undici modelli con fotocamera, otto modelli audio e una voce elettrocromica senza fotocamera, e questo dato riflette una convenzione di denominazione della gamma anziché affermare che venti prodotti condividano la stessa implementazione. Per il gruppo delle fotocamere pubblichiamo la capacità della batteria, l’interfaccia di ricarica, la classe di risoluzione, l’autonomia nominale e il tempo di ricarica; gli otto modelli audio pubblicano inoltre una versione Bluetooth, mentre la serie di fotocamere non ne pubblica alcuna. Nel catalogo completo compare un solo peso, 158 g per la piattaforma con fotocamera MT6, escluso il case di ricarica pieghevole, e nessun modello pubblica il peso per una configurazione dotata di AI.
La lacuna è coerente e spiegabile: pubblichiamo i dati del prodotto che assembliamo, non le caratteristiche di implementazione di una funzionalità fornita da qualcun altro. La stessa regola vale per la lente in un programma fotocromico e per la posizione relativa alle qualifiche radio: il nostro catalogo riporta una dichiarazione sulla certificazione per l’exportazione a livello aziendale, ma non una riga di certificazione per ogni modello. Si tratta di una regola su ciò che possiamo documentare in modo trasparente, applicata a ogni prodotto che elenchiamo.
È anche per questo motivo che non possiamo pubblicare una versione completa di questo modello per i nostri prodotti. Non esiste una versione completa da pubblicare e scriverne una significherebbe inventare condizioni oppure prenderle in prestito da un fornitore; nessuna delle due opzioni sopravvivrebbe al primo cliente che chiede come sia stato ottenuto il dato.
Il contesto della funzionalità è descritto in funzionalità AI degli occhiali smart. I limiti che questo test evidenzia sono riportati in i limiti delle funzionalità IA degli occhiali smart che conosciamo, il metodo per valutare le dichiarazioni è illustrato in dichiarazioni dei produttori sulle funzionalità IA degli occhiali smart, gli aspetti da definire prima di iniziare i test sono elencati in checklist per l’acquisto delle funzionalità IA degli occhiali smart e il protocollo di campionamento è disponibile in valutazione dei campioni.
Letture correlate
- Lo scopo di questo test — limiti e svantaggi delle funzionalità IA degli occhiali smart
- Gli aspetti da definire prima dei test — checklist per l’acquisto delle funzionalità IA degli occhiali smart
- Il protocollo di campionamento — valutazione dei campioni
Inviaci uno studio che hai condotto e ti diremo quali risultati sono in linea con le nostre voci pubblicate.


