
Um estudo de caso sobre uma funcionalidade de IA quase nunca pode ser publicado, pois relata um resultado sem as condições que o produziram. Smart glasses ai features smart glasses case study template não é, portanto, realmente um modelo de publicação — é uma forma de produzir evidências sobre uma capacidade que não pode ser especificada previamente. Se você leu o restante da nossa cobertura sobre IA, já sabe que nossa documentação não publica nenhuma precisão, cobertura de idiomas, latência ou detalhe de arquitetura para nenhum dos nossos 28 modelos, o que significa que não existe nenhum estudo desse tipo conosco para você reproduzir.
Essa ausência é o motivo pelo qual este modelo é importante. Na maioria das categorias, um comprador pode escrever uma especificação e verificar o fornecedor em conformidade com ela. Na categoria de IA, as questões sobre capacidade — precisão, cobertura de idiomas, comportamento offline, latência — não podem ser resolvidas com base na documentação, pois, nessa faixa, não há nada a consultar, e o mesmo vale, em grande medida, para a maioria dos fornecedores. Portanto, a amostra é o instrumento de medição. É o único dispositivo disponível para produzir um número específico para o seu produto.
Funcionalidades de IA dos óculos inteligentes: por que os estudos não podem ser publicados
O problema estrutural
Um estudo de caso é um relatório sobre algo que aconteceu, e um relatório só é útil quando o leitor consegue identificar o que aconteceu por causa de quais condições. A maioria dos estudos sobre funcionalidades de IA falha nesse teste de uma de três maneiras.
As condições estão ausentes. O estudo relata "92% de precisão em consultas de clientes" sem conjunto de conteúdo, par de idiomas, condição de rede ou data. Esse número não é uma medição — é um número cujo referente foi removido, e não pode ser reproduzido por você nem por mais ninguém.
As falhas estão ausentes. O estudo relata o que funcionou. Um relatório de sucessos é uma demonstração, e a lista de falhas é a parte que possui valor de engenharia. É também a parte que informa ao comprador se a funcionalidade é capaz de sustentar uma alegação de marketing.
O requisito está ausente. O estudo foi realizado sem uma declaração escrita do que a funcionalidade deveria fazer, portanto, produz dados, mas não uma decisão. Essa é a falha mais comum e a mais cara, pois o comprador acaba comparando os dados com uma expectativa que nunca foi registrada e, por isso, não pode ser verificada.
Por que a documentação não substitui o estudo
As questões sobre capacidade nessa categoria não são publicadas. Nem por nós e — pelo que os compradores nos dizem — nem pela maioria dos fornecedores. Não existe um método de teste padrão para a precisão da IA em um dispositivo vestível, uma condição padronizada de medição de latência nem uma definição padrão do que significa "suporte offline".
Na prática, isso significa que a amostra é o instrumento de medição, e são necessárias cerca de um dia de trabalho para produzir algo defensável. Um dia representa um custo real para o cronograma de lançamento, mas é um custo muito pequeno comparado à alternativa de descobrir o comportamento depois que o anúncio já está no ar.
Para que serve um modelo
Um modelo nesta categoria não é um formato de documento. É um protocolo e existe para fazer com que duas coisas sejam verdadeiras ao mesmo tempo: que o resultado seja específico o suficiente para permitir uma ação e que outra pessoa possa repeti-lo.
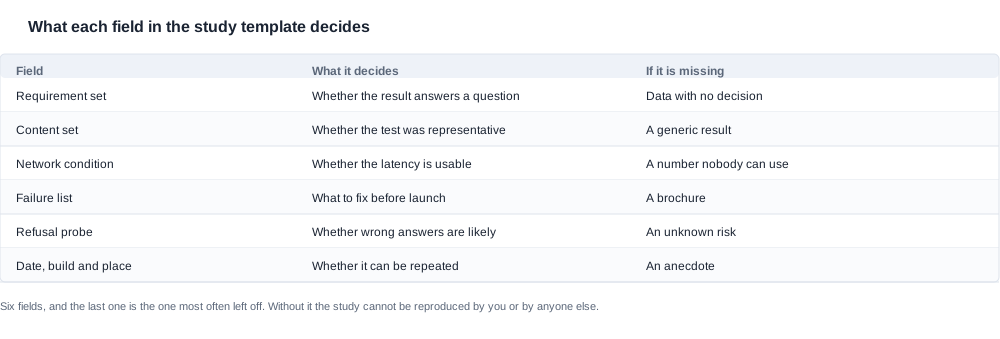
Os seis campos a seguir são o mínimo necessário para isso. Cada um deles elimina uma falha específica, e um estudo que não contiver qualquer um deles não deve ser distribuído como evidência — não porque seja desonesto, mas porque não permite embasar uma decisão.
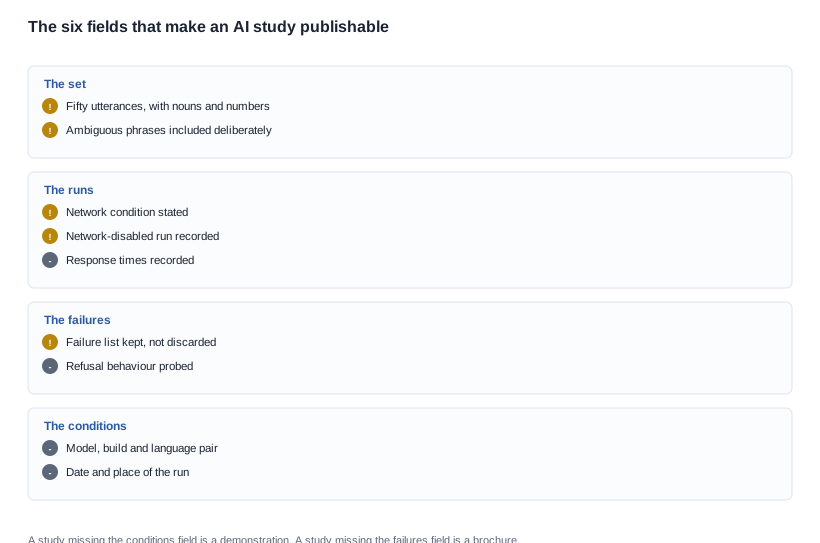
Os seis campos que tornam um estudo reproduzível
Campo um: o conjunto de requisitos
Uma declaração escrita do que a funcionalidade deve fazer, redigida antes do primeiro comando e com data. Não uma lista de comportamentos desejáveis — um limite para cada função, nos termos que o canal de fato considera importantes.
Para uma funcionalidade de tradução em um canal varejista, o conjunto de requisitos poderia ser: o par de idiomas deve ser tratado para os idiomas listados; uma solicitação falada deve ser transcrita com precisão suficiente para permitir uma ação; a resposta deve chegar dentro de um tempo definido, em uma conexão definida; e, quando o sistema tiver dúvida, ele deve informar isso em vez de produzir uma resposta fluente.
O conjunto de requisitos é o que transforma o estudo de uma descrição em uma decisão, e é o campo mais frequentemente ignorado porque parece burocracia até o dia em que é preciso decidir se um resultado atende aos requisitos.
Campo dois: o conjunto de conteúdo
Cinquenta frases semelhantes ao que seu cliente realmente dirá. Inclua nomes próprios, números, unidades, códigos de produto, nomes que poderiam se referir a duas coisas diferentes e expressões deliberadamente ambíguas.
Um conjunto de testes genéricos produz um resultado genérico que nada informa sobre o seu produto. Trinta frases fáceis e vinte difíceis, com as difíceis escritas para serem difíceis, constituem um conjunto melhor do que cinquenta que um script de demonstração também passaria.
O conjunto deve ser escrito por alguém que conheça o canal, não por quem tenha mais tempo. Um responsável de suporte que leu mil chamados da sua categoria escreverá um conjunto de conteúdo melhor do que um engenheiro trabalhando a partir de uma lista de funcionalidades, porque sabe quais expressões realmente ocorrem e quais são mal interpretadas.
Campo três: a condição de rede
A condição da conexão durante a realização de cada execução. Mais útil seria informar: a condição normal para o seu pior mercado, e não a condição da sala de demonstração do fornecedor.
Se o seu canal inclui mercados com conectividade inconsistente, então a condição “normal” para o estudo será uma conexão ruim, e o resultado dirá se a funcionalidade é utilizável nesse contexto ou se está apenas presente. Este é o campo mais frequentemente omitido e o que mais altera a conclusão.
Campo quatro: a execução sem rede
O campo mais frequentemente omitido e o que determina onde o produto pode ser utilizado. Desligue a rede e enumere o que continua funcionando: captura, chamadas, reprodução, assistente e configurações.
Se o seu cliente utilizar o produto em um armazém, porão ou no exterior com uma conexão ruim, essa será a condição de utilização, e não um caso excepcional. A execução sem rede dirá se a funcionalidade de IA pode ser uma dependência ou apenas um complemento — e, portanto, se você pode apresentá-la na embalagem como motivo para comprar o produto.
Campo cinco: a lista de falhas
Registre as falhas de forma específica, incluindo a entrada, a saída e o motivo da falha. Não uma contagem — uma lista.
Uma contagem informa uma taxa, e uma taxa sem as entradas que a originaram não permite tomar medidas. A lista informa quais entradas provavelmente causarão problemas, e é a partir dela que se escrevem o script de suporte, o briefing de treinamento e as ressalvas do anúncio.
Campo seis: as condições, a versão e o local
O modelo, a versão do firmware, a data, o local, o par de idiomas, o identificador da unidade e a ferramenta utilizada para medir o tempo. Este é o campo que mais frequentemente fica de fora e o que faz a diferença entre um estudo e uma anedota.
Sem ele, você não pode reproduzir um resultado — o que significa que ele não pode ser reproduzido por ninguém, porque as unidades testadas já foram descartadas e o firmware foi atualizado desde então.
Como criar o conjunto de conteúdo que realmente testa a funcionalidade
Um método que produz resultados comparáveis
O conjunto de conteúdo é a parte do modelo em que se concentra a maior parte do julgamento, e vale ser preciso sobre como criar um conjunto que outro engenheiro possa utilizar.
Comece com entradas reais, não plausíveis. A melhor fonte são os chamados de suporte, as transcrições de chamadas, os registros de consultas ou as notas de voz que o seu canal já recebe. Faça uma amostra delas e remova as informações pessoais. Se o canal for novo, a segunda melhor fonte são as dez perguntas que um vendedor recebe com mais frequência, escritas com a formulação do cliente, e não a do produto.
Aumente a dificuldade de forma deliberada. Divida as cinquenta entradas em três níveis e mantenha a contagem de cada um nas suas anotações: as solicitações que uma demonstração passaria, as solicitações que contêm um nome próprio, número ou unidade, e as solicitações que são genuinamente ambíguas — um nome que pode pertencer a duas pessoas, um número sem contexto ou uma expressão com duas interpretações. O terceiro nível é onde reside o valor para a engenharia e é onde o risco de uma resposta fluentemente errada se manifesta.
Inclua os casos negativos de forma deliberada. Todo conjunto precisa de prompts que devem ser recusados ou que não têm resposta correta. Um sistema que retorna uma resposta absurdo, mas falante e confiante, causa mais dano do que um sistema que não retorna nada. Isso passa despercebido em uma demonstração, porque as demonstrações são compostas por prompts que funcionam.
Escreva o conjunto antes de a amostra chegar, ou pelo menos antes de vê-la funcionar. Um conjunto escrito depois dos resultados descreve o produto em vez de testá-lo, e essa diferença não é detectável pela saída — só é possível detectá-la sabendo o que você pretendia incluir.
Executando o conjunto e registrando o que acontece
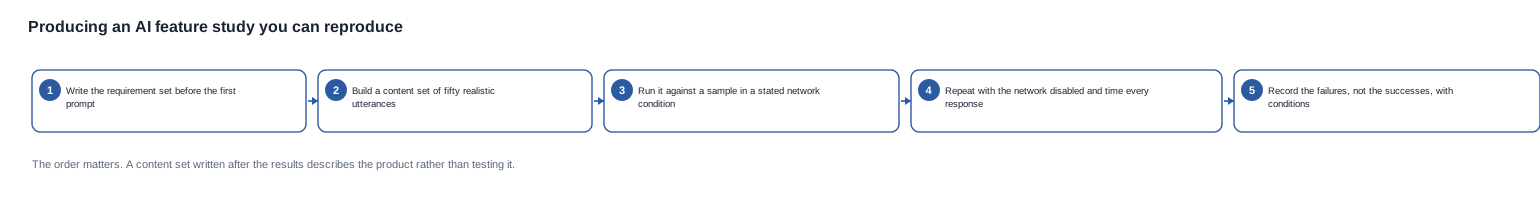
Execute cada prompt em uma amostra, em uma condição de rede declarada, e registre quatro informações por prompt: o que foi dito, o que foi retornado, quanto tempo levou e se a resposta estava correta, incompleta, errada ou foi corretamente recusada.
Meça cada resposta em relação a um limiar fixo, em vez de registrar apenas o número bruto. Uma métrica bruta de latência, sem um limiar associado, não informa se o recurso é utilizável; um limiar o classifica como aprovado ou reprovado, e essa classificação pode ser incluída em uma especificação.
Repita a execução sem rede com o mesmo conjunto e registre o que continua respondendo. Quando um comando do primeiro conjunto passa a falhar com a rede desligada, ele integra o conjunto de limitações da sua listagem.
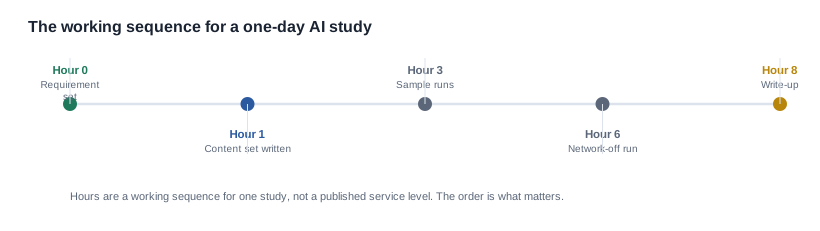
A sequência de trabalho abaixo cabe confortavelmente em um dia para um produto e um recurso, e foi deliberadamente ordenada para que as execuções mais difíceis ocorram enquanto a equipe ainda está atenta.
Três públicos, três versões do mesmo estudo
Um estudo normalmente precisa atender a três tipos de leitores, e o erro é tentar atender aos três com um único documento. Cada um precisa de informações diferentes e de níveis distintos de detalhe.
A equipe interna — produto, suporte e marketing — precisa da lista de falhas e do conjunto de limitações. Precisa saber quais entradas falham e o que o recurso faz sem conexão, pois é a partir dessas informações que se elaboram o roteiro de suporte e o briefing de treinamento. Não precisa dos tempos brutos de cada comando; precisa do limiar e de saber se ele foi atingido.
O fornecedor precisa do conjunto de requisitos, do conjunto de conteúdo e da lista de falhas, em um formato sobre o qual possa agir. Vale enviar o próprio conjunto de conteúdo, pois um fornecedor que vê os comandos exatos consegue reproduzir a execução e explicar as falhas, o que é mais rápido do que tentar descrever cinquenta falas por e-mail.
A equipe voltada ao cliente — o canal, a equipe das lojas e o revendedor — precisa de uma página. O que o recurso faz bem, o que não consegue fazer e o que dizer quando um cliente solicita algo fora de seu escopo. Essa página deve ser escrita por último, porque precisa ser verdadeira e só se torna verdadeira depois que as falhas são conhecidas.
Escrevê-los nessa ordem também evita que o estudo seja moldado pelo público de marketing. Se a listagem for escrita primeiro, o conjunto de conteúdo tende a ser criado a partir das frases que o texto de divulgação já promete, e o estudo passa a confirmar o texto em vez de testar o produto. Esse é o modo de falha que este modelo completo existe para evitar.
Manter o estudo útil após o lançamento
Um estudo costuma ser mais valioso nos meses após o lançamento, quando chega a primeira leva de consultas reais e ficam visíveis as lacunas entre o conjunto de testes e a realidade.
Dois hábitos possibilitam isso. Retainha o conjunto de conteúdo e as condições junto com o estudo, em vez de guardar apenas os resultados, para que uma execução posterior possa ser comparada com a primeira. E agende uma nova execução com um intervalo e um gatilho definidos — após uma atualização de firmware, após uma mudança de fornecedor e antes de qualquer campanha importante que gere tráfego fora do padrão. Um recurso de IA que mudou desde o último estudo é um recurso cuja listagem pode não corresponder mais à realidade, e o custo de perceber isso por meio de um estudo é muito menor do que o custo de perceber por meio de uma reclamação.
Transformar um estudo em uma decisão, e não em um documento
Compare com seu conjunto de requisitos, não com outro produto
Se você definiu o que o recurso deve fazer antes dos testes, agora tem uma resposta sobre a qual pode agir. Se não definiu, tem dados, mas nenhuma pergunta. Essa é toda a razão pela qual o primeiro campo existe, e vale reforçá-la porque é neste ponto que a maioria dos estudos erra.
Comparar seu resultado com o resultado de outro fornecedor quase sempre é um erro nesta categoria, porque os dois resultados foram obtidos em condições diferentes, com conjuntos de conteúdo e limiares diferentes. Você acabará escolhendo com base no número, e não nas evidências.
A comparação que funciona tem três frentes: seu resultado em relação ao seu conjunto de requisitos, seu resultado em relação ao mesmo conjunto de requisitos dos outros fornecedores e a diferença entre eles em relação ao custo dessa diferença. A terceira etapa é aquela que os compradores ignoram, e é a que transforma um resultado de teste em uma decisão de compra.
Documente de modo que outra pessoa possa repetir o estudo
Isso significa registrar o conjunto de conteúdo, as condições e o método — não a conclusão. Um resultado que outro engenheiro não consegue reproduzir é uma afirmação com uma tabela anexada.
O relatório deve ser curto o suficiente para ser lido por um colega e completo o suficiente para que ele possa realizá-lo. Na prática, isso significa: o conjunto de requisitos, o conjunto de conteúdo na forma dos cinquenta prompts reais, a tabela de condições, a tabela de resultados com as falhas listadas e uma conclusão em um parágrafo, indicando quais requisitos foram aprovados e quais não foram.
Determine o caso de degradação a partir do resultado
O teste com a rede desligada é o que determina se o recurso pode ser uma dependência ou apenas uma melhoria. Se a degradação for aceitável, o recurso pode carregar com segurança peso comercial. Se a degradação fizer o produto deixar de cumprir a função pela qual foi adquirido, será necessário alterar o texto ou o produto, e ambas as alternativas são mais baratas de decidir aqui do que após o lançamento.
Uma segunda decisão decorre da lista de falhas: se o modo de falha é visível. Um sistema que diz "Não identifiquei isso" é apenas uma linha do roteiro de suporte. Um sistema que responde com confiança e incorretamente é uma categoria completamente diferente de problema, e não aparecerá no seu próprio conjunto de testes se ele for educationado demais.
A consequência comercial do estudo
Um estudo concluído altera três posições comerciais, e vale a pena utilizá-lo deliberadamente em vez de deixá-lo esquecido em uma pasta.
Os critérios de aceitação do pedido. Os limites que você mediu se tornam os critérios do pedido de compra, e um lote que não os atende é um lote que você pode recusar. Sem o estudo, não há nada contra o qual recusar.
A garantia. Uma garantia redigida com base no critério de falha do campo seis é mensurável no momento de uma solicitação. Uma garantia redigida com base em uma descrição é uma negociação.
O anúncio. A lista de falhas e o teste com a rede desligada redigem o seu texto. Uma descrição restrita, construída a partir de um resultado medido, é defensável; uma descrição ampla, construída a partir de uma demonstração, não é.
O que a nossa própria posição deixa em aberto
A nossa documentação menciona a capacidade de assistente de voz com IA em todas as plataformas de câmera e descreve o suporte à tradução por IA no site independente. Não publica nenhum índice de precisão, lista de idiomas compatíveis, latência, comportamento offline, local de processamento, condições de assinatura nem jurisdição de dados.
Isso significa que não podemos fornecer uma versão completa deste modelo para os nossos próprios produtos e preferimos declará-lo a publicar um estudo cujas condições não conseguimos descrever. Também significa que, se você realizar este teste com uma de nossas amostras, produzirá evidências que mais ninguém na cadeia tem — uma posição estranha para um fabricante, mas útil para um comprador.
Podemos oferecer a outra metade. Envie-nos um estudo que você tenha realizado com uma de nossas amostras e informaremos quais resultados são compatíveis com as linhas que publicamos e quais não são. Um resultado que conflita com algo na nossa documentação vale a pena conhecer, para qualquer um de nós.
Para fins de contexto sobre o que o nosso catálogo inclui e não inclui: vinte das 28 entradas de modelos são designadas como produtos de IA — onze modelos de câmera, oito modelos de áudio e uma entrada eletrocrômica sem câmera — e esse número é uma convenção de nomenclatura da linha, não uma declaração de que vinte produtos compartilham a mesma implementação. Em todo o grupo de câmeras, publicamos a capacidade da bateria, a interface de carregamento, a classe de resolução, a autonomia nominal e o tempo de carregamento; os oito modelos de áudio também publicam uma versão do Bluetooth, enquanto a série de câmeras não publica nenhuma. No catálogo inteiro, aparece apenas um peso: 158 g para a plataforma de câmera MT6, sem o estojo de carregamento dobrável. Nenhum modelo publica um peso para uma configuração equipada com IA.
A lacuna é consistente e pode ser explicada: publicamos as linhas dos produtos que montamos, e não as características de implementação de um recurso fornecido por terceiros. A mesma regra se aplica à lente de um programa fotocrômico e à posição da qualificação de rádio, na qual o nosso catálogo inclui uma declaração de certificação de exportação no nível da empresa, mas não uma linha de certificação por modelo. É uma regra sobre o que podemos comprovar honestamente, e aplica-se a todos os produtos listados.
É por isso também que não podemos publicar uma versão completa deste modelo para os nossos próprios produtos. Não existe uma versão completa para publicar, e redactar uma exigiria inventar condições ou utilizar as de um fornecedor; nenhuma das alternativas sobreviveria ao primeiro cliente que perguntasse como o número foi obtido.
O contexto do recurso está em funcionalidades de IA dos óculos. As limitações identificadas por este teste estão em as limitações das funcionalidades de IA que conhecemos, o método de verificação está em as alegações dos fabricantes sobre funcionalidades de IA, os itens a estabelecer antes de iniciar os testes estão em a lista de verificação de funcionalidades de IA para equipes de compras e o próprio protocolo de avaliação está em avaliação de amostras.
Leituras relacionadas
- O que este teste foi projetado para identificar — limitações e desvantagens das funcionalidades de IA
- Os itens a estabelecer antes dos testes — lista de verificação de funcionalidades de IA para equipes de compras
- O próprio protocolo de avaliação — avaliação de amostras
Envie-nos um estudo que você conduct e informaremos quais constatações estão alinhadas aos nossos itens publicados.


