
Une étude de cas portant sur une fonctionnalité IA est presque toujours impossible à publier, car elle présente un résultat sans les conditions qui l’ont produit. Le modèle d’étude de cas pour les fonctionnalités IA des lunettes connectées n’est donc pas vraiment un modèle de publication: c’est un moyen de produire des preuves sur une capacité qui ne peut pas être définie à l’avance. Si vous avez lu le reste de notreActualité IA, vous savez déjà que notre documentation ne publie aucun chiffre de précision, aucune couverture linguistique, aucune latence ni aucun détail architectural pour nos 28 modèles, ce qui signifie qu’aucune étude de ce type n’existe de notre côté pour que vous puissiez la reproduire.
C’est cette absence qui rend ce modèle important. Dans la plupart des catégories, un acheteur peut rédiger un cahier des charges et vérifier le fournisseur par rapport à celui-ci. Dans la catégorie IA, les questions relatives aux capacités — précision, couverture linguistique, fonctionnement hors ligne, latence — ne peuvent pas être résolues à partir de la documentation, car, dans ce secteur, il n’y a rien à consulter, et cela vaut globalement pour la plupart des fournisseurs. L’échantillon est donc l’instrument de mesure. C’est le seul outil dont vous disposez pour produire un chiffre spécifique à votre produit.
Fonctionnalités IA des lunettes connectées: pourquoi les études sont impossibles à publier
Le problème structurel
Une étude de cas est un rapport sur quelque chose qui s’est produit, et un rapport n’est utile que si le lecteur peut déterminer ce qui s’est produit à cause de quelles conditions. La plupart des études sur les fonctionnalités IA échouent à ce test de trois façons.
Les conditions sont manquantes. L’étude indique « 92 % de précision sur les requêtes des clients », sans ensemble de contenus, sans paire de langues, sans condition réseau ni date. Ce chiffre n’est pas une mesure: c’est un nombre dont la référence a été supprimée, et que ni vous ni personne d’autre ne peut reproduire.
Les échecs sont manquants. L’étude présente ce qui a fonctionné. Un rapport sur les réussites est une démonstration, et la liste des échecs est la partie qui recouvre une réelle valeur technique. C’est aussi la partie qui indique à l’acheteur si la fonctionnalité peut soutenir une promesse marketing.
Le besoin est manquant. L’étude a été menée sans déclaration écrite de ce que la fonctionnalité devait accomplir; elle produit donc des données, mais aucune décision. C’est l’échec le plus fréquent et le plus coûteux, car l’acheteur finit par comparer les données à une attente qui n’a jamais été consignée et qui ne peut donc pas être vérifiée.
Pourquoi la documentation ne peut pas remplacer l’étude
Les questions relatives aux capacités dans cette catégorie ne sont pas publiées. Ni par nous et — d’après ce que les acheteurs nous disent — ni par la plupart des fournisseurs non plus. Il n’existe aucune méthode d’essai standard pour la précision de l’IA sur un objet wearable, aucune condition standard de mesure de la latence et aucune définition standard de ce que signifie « prise en charge hors ligne ».
Concrètement, cela signifie que l’échantillon est l’instrument de mesure et qu’il faut environ une journée de travail pour produire un résultat défendable. Une journée représente un coût réel au regard du calendrier de lancement, mais un coût très faible comparé à l’alternative consistant à découvrir le comportement une fois l’annonce en ligne.
À quoi sert un modèle
Un modèle dans cette catégorie n’est pas un format de document. C’est un protocole, et il existe pour permettre deux choses à la fois: un résultat suffisamment précis pour être exploité et la possibilité pour quelqu’un d’autre de le répéter.
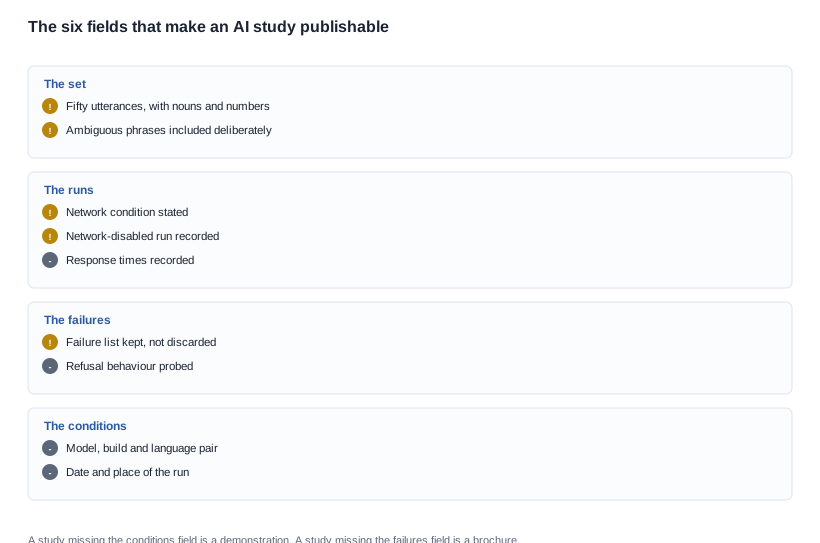
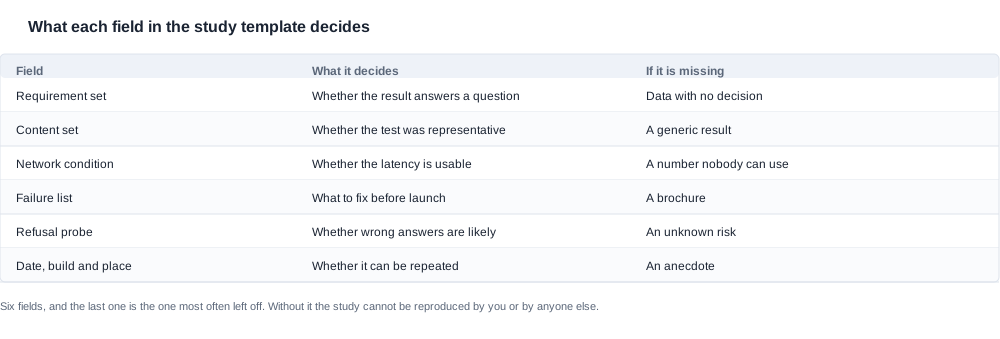
Les six champs ci-dessous constituent le minimum requis. Chacun corrige un échec précis, et une étude à laquelle il manque l’un d’eux ne doit pas être diffusée comme preuve — non pas parce qu’elle serait malhonnête, mais parce qu’elle ne peut pas étayer une décision.
Les six champs qui rendent une étude reproductible
Premier champ: le cahier des charges
Une déclaration écrite de ce que la fonctionnalité doit faire, rédigée avant la première invite et datée. Pas une liste de comportements souhaitables, mais un seuil par fonction, formulé selon les critères qui comptent réellement pour le canal concerné.
Pour une fonctionnalité de traduction dans un canal de vente au détail, le cahier des charges pourrait être le suivant: la paire de langues doit être prise en charge pour les langues indiquées; une demande orale doit être transcrite avec une précision suffisante pour être traitée; la réponse doit arriver dans un délai défini sur une connexion précisée; et, lorsque le système est incertain, il doit le signaler plutôt que produire une réponse fluide.
Le cahier des charges transforme l’étude d’une description en décision. C’est le champ le plus souvent négligé parce qu’il ressemble à une formalité administrative jusqu’au jour où vous devez déterminer si un résultat est conforme.
Deuxième champ: l’ensemble de contenus
Cinquante phrases ressemblant à ce que votre client dira réellement. Incluez des noms propres, des nombres, des unités, des codes produit, des noms pouvant désigner deux choses différentes et des expressions volontairement ambiguës.
Un ensemble de test générique produit un résultat générique qui ne vous apprend rien sur votre produit. Trente phrases faciles et vingt difficiles, ces dernières étant formulées pour être réellement difficiles, constituent un meilleur ensemble que cinquante phrases qu’un script de démonstration réussirait également.
L’ensemble doit être rédigé par une personne qui connaît le canal, et non par celle qui a le plus de temps. Un responsable du support ayant lu mille tickets pour votre catégorie rédigera un meilleur ensemble de contenu qu’un ingénieur travaillant à partir d’une liste de fonctionnalités, car il sait quelles expressions apparaissent réellement et lesquelles sont mal comprises.
Champ trois: l’état du réseau
Ce que la connexion était au moment de chaque exécution. La formulation la plus utile est: l’état normal pour votre marché le plus difficile, et non celui de la salle de démonstration du fournisseur.
Si votre canal inclut des marchés où la connectivité est irrégulière, une connexion « normale » pour l’étude correspondra à une connexion médiocre, et le résultat vous dira si la fonctionnalité y est utilisable ou seulement disponible. C’est le champ le plus souvent laissé implicite, et celui qui influence le plus la conclusion.
Champ quatre: l’exécution hors réseau
Le champ le plus souvent omis, et celui qui détermine où le produit peut être utilisé. Coupez le réseau et énumérez ce qui fonctionne encore: la capture, les appels, la lecture, l’assistant, les paramètres.
Si votre client utilisera ce produit dans un entrepôt, dans un sous-sol ou à l’étranger avec une connexion médiocre, il s’agit de la condition d’utilisation normale et non d’un cas limite. L’exécution hors réseau vous indique si la fonctionnalité IA peut constituer une dépendance ou seulement un amélioration — et donc si vous pouvez la mettre en avant sur l’emballage comme raison d’achat.
Champ cinq: la liste des échecs
Consignez précisément les échecs, avec l’entrée, la sortie et la raison de l’échec. Pas un décompte — une liste.
Un décompte vous donne un taux, et un taux sans les entrées correspondantes est inutilisable. La liste vous indique avec quelles entrées vous pouvez vous attendre à des problèmes, et c’est à partir de cette liste que sont rédigés un script de support, une note de formation et une mention de prudence sur une fiche produit.
Champ six: les conditions, la version et le lieu
Le modèle, la version du micrologiciel, la date, le lieu, la paire de langues, l’identifiant de l’unité et l’outil utilisé pour le chronométrage. C’est le champ le plus souvent omis, et celui qui fait la différence entre une étude et une anecdote.
Sans lui, vous ne pouvez pas reproduire un résultat — ce qui signifie qu’il ne peut pas être reproduit du tout, car les unités testées n’existent plus et le micrologiciel a été mis à jour depuis.
Construire l’ensemble de contenu qui teste réellement la fonctionnalité
Une méthode qui produit des résultats comparables
L’ensemble de contenu est la partie du modèle où reside l’essentiel du jugement. Il convient donc d’être précis sur la manière d’en construire un que pourrait utiliser un autre ingénieur.
Partez de entrées réelles, et non d’entrées plausibles. La meilleure source reste les tickets de support, les transcriptions d’appels, les journaux de requêtes ou les notes vocales que votre canal reçoit déjà. Prélevez des éléments parmi eux, puis normalisez-les afin de supprimer les informations personnelles. Si le canal est nouveau, la deuxième meilleure source correspond aux dix questions les plus fréquemment posées à un vendeur, formulées avec les termes du client plutôt qu’avec ceux du produit.
Organisez deliberément les niveaux de difficulté. Répartissez les cinquante éléments en trois niveaux et conservez le nombre de chacun dans vos notes: les requêtes qu’une démonstration réussirait, les requêtes contenant un nom propre, un nombre ou une unité, et les requêtes véritablement ambiguës — un nom pouvant désigner deux personnes, un nombre sans contexte, une expression pouvant avoir deux interprétations. Le troisième niveau abrite l’essentiel de la valeur technique et le risque de voir le système produire une réponse fluide mais incorrecte.
Intégrez délibérément les cas négatifs. Chaque ensemble doit contenir des requêtes qui devraient être refusées ou qui n’ont pas de réponse correcte. Un système qui renvoie une absence de sens sûre et fluide cause davantage de dégâts qu’un système qui ne renvoie rien. Ce risque reste invisible lors d’une démonstration, car les démonstrations sontzzi composées de requêtes qui fonctionnent.
Rédigez l’ensemble avant de recevoir l’échantillon, ou au moins avant de l’avoir vu fonctionner. Un ensemble rédigé après les résultats décrit le produit au lieu de le tester, et cette différence n’est pas détectable à partir de la sortie — elle ne l’est que si l’on sait ce que l’on avait prévu d’inclure.
L’exécuter et consigner ce qui se produit
Exécutez chaque requête sur un échantillon, dans un état de réseau spécifié, et consignez quatre éléments par requête: ce qui a été dit, ce qui a été renvoyé, le temps nécessaire et si la réponse était correcte, incomplète, erronée ou refusée à juste titre.
Mesurez chaque réponse selon un seuil fixe plutôt que de consigner uniquement le chiffre brut. Une latence brute dépourvue de seuil ne vous apprend rien sur l’exploitabilité de la fonctionnalité; un seuil permet de déterminer si le test est réussi ou échoué, et ce résultat peut être intégré à une spécification.
Répétez le test hors réseau sur le même ensemble et consignez ce qui continue de répondre. Si une invite du premier ensemble échoue désormais lorsque le réseau est coupé, elle appartient à l’ensemble des limitations de votre fiche.
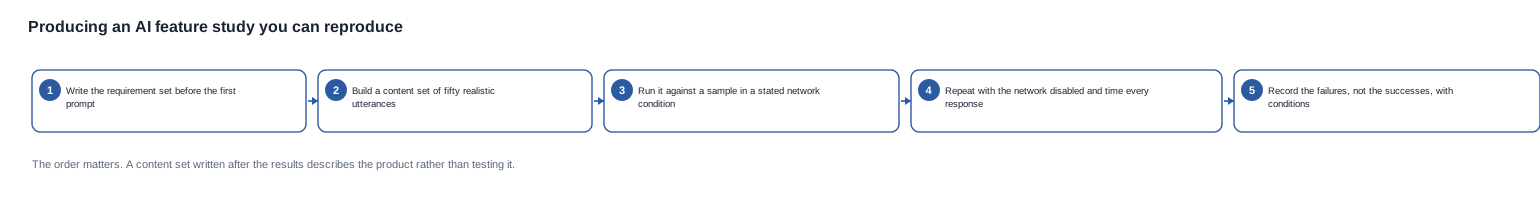
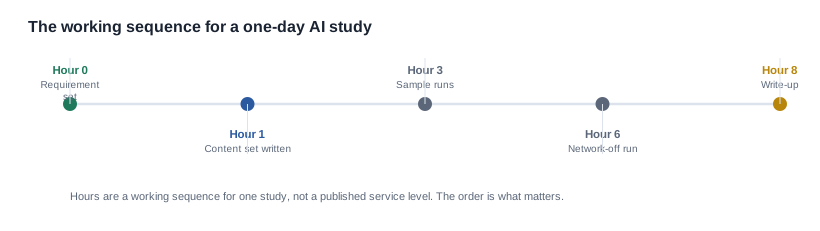
La séquence de travail ci-dessous s’intègre confortablement dans une journée pour un produit et une fonctionnalité. Elle est délibérément ordonnée de sorte que les tests les plus complexes soient réalisés pendant que l’équipe est encore attentive.
Trois publics, trois versions de la même étude
Une étude doit généralement servir trois types de lecteurs, et l’erreur consiste à rédiger un seul document qui tente de répondre à leurs besoins à tous. Ils attendent des informations différentes, avec des niveaux de détail différents.
L’équipe interne — produit, support et marketing — a besoin de la liste des échecs et de l’ensemble des limitations. Elle doit savoir quelles entrées échouent et comment la fonctionnalité se comporte sans connexion, puisque le script du support et la formation s’appuient sur ces informations. Elle n’a pas besoin des temps de réponse bruts pour chaque invite, mais du seuil et de l’indication de savoir s’il a été atteint.
Le fournisseur a besoin de l’ensemble des exigences, de l’ensemble du contenu et de la liste des échecs, sous une forme exploitable. Il vaut la peine de lui transmettre directement l’ensemble du contenu: un fournisseur qui voit les invites exactes peut reproduire le test et expliquer les échecs, ce qui est plus rapide que d’essayer de décrire cinquante formulations dans un e-mail.
L’équipe en contact avec les clients — la distribution, le personnel en magasin, le revendeur — a besoin d’une seule page: ce que la fonctionnalité fait bien, ce qu’elle ne peut pas faire et quoi dire lorsqu’un client demande quelque chose qui dépasse ses capacités. Cette page est la dernière à rédiger, car c’est celle qui doit être exacte, et elle ne le devient qu’une fois les échecs connus.
Les rédiger dans cet ordre évite également que l’étude soit façonnée par le public marketing. Si la fiche est rédigée en premier, l’ensemble du contenu a tendance à être construit à partir des phrases que le texte de présentation promet déjà, et l’étude confirme alors la communication au lieu de tester le produit. C’est précisément le mode de défaillance que l’ensemble de ce modèle existe pour empêcher.
Maintenir l’utilité de l’étude après la commercialisation
Une étude est généralement la plus utile dans les mois suivant la commercialisation, lorsque la première vague de requêtes réelles arrive et que les écarts entre l’ensemble de test et la réalité deviennent visibles.
Deux habitudes permettent d’y parvenir. Conservez l’ensemble du contenu et les conditions de test avec l’étude, plutôt que les seuls résultats, afin qu’une exécution ultérieure soit comparable à la première. Et planifiez une nouvelle exécution selon un intervalle et un déclencheur définis — après une mise à jour du firmware, après un changement de fournisseur et avant toute campagne majeure susceptible de générer un trafic inhabituel. Une fonctionnalité IA qui a évolué depuis la dernière étude est une fonctionnalité dont la fiche n’est peut-être plus exacte, et le coût de le constater grâce à une étude est bien inférieur au coût de le découvrir à la suite d’une réclamation.
Transformer une étude en décision plutôt qu’en document
Comparez les résultats à votre ensemble d’exigences, et non à un autre produit
Si vous avez défini ce que la fonctionnalité doit faire avant les tests, vous disposez désormais d’une réponse exploitable. Dans le cas contraire, vous avez des données, mais pas de question à poser. C’est la raison d’être du premier champ, et il convient de le rappeler car c’est à ce stade que la plupart des études échouent.
Comparer vos résultats à ceux d’un autre fournisseur constitue presque toujours une erreur dans cette catégorie, car les deux résultats ont été obtenus dans des conditions différentes, sur des ensembles de contenu différents et avec des seuils distincts. Vous finirez ainsi par vous fonder sur le chiffre plutôt que sur les éléments de preuve.
La comparaison qui fonctionne repose sur trois axes: vos résultats par rapport à votre ensemble d’exigences, vos résultats par rapport au même ensemble d’exigences appliqué aux autres fournisseurs, et l’écart entre ces résultats évalué au regard de son coût. La troisième étape est celle que les acheteurs négligent, et c’est elle qui transforme un résultat de test en décision d’achat.
Rédigez l’étude de manière qu’une autre personne puisse la reproduire
Cela signifie consigner l’ensemble du contenu, les conditions et la méthode — et non la conclusion. Un résultat qu’un autre ingénieur ne peut pas reproduire n’est qu’une affirmation assortie d’un tableau.
Le compte rendu doit être assez court pour qu’un collègue le lise et suffisamment complet pour qu’il puisse l’exécuter. En pratique, cela signifie: l’ensemble des exigences, l’ensemble du contenu sous la forme des cinquante invites réelles, le tableau des conditions, le tableau des résultats avec les échecs consignés et une conclusion d’un paragraphe indiquant les exigences satisfaites et celles qui ne le sont pas.
Déterminer le scénario de dégradation à partir des résultats
L’essai sans réseau est celui qui détermine si la fonctionnalité peut être une dépendance ou seulement une amélioration. Si la dégradation est acceptable, la fonctionnalité peutheroes porter une valeur marketing en toute sécurité. Si la dégradation signifie que le produit cesse de faire ce pour quoi il a été acheté, alors soit le texte change, soit le produit change, et dans les deux cas, il est moins coûteux de trancher ici qu’après le lancement.
Une deuxième décision découle de la liste des échecs: le mode de défaillance est-il visible? Un système qui dit « Je n’ai pas capté cela » relève d’une réponse predefined pour le support. Un système qui répond avec assurance, mais de manière incorrecte, relève d’une tout autre catégorie de problèmes, et c’est précisément celui qui n’apparaîtra pas dans votre propre jeu de tests si celui-ci est trop indulgenceant.
La conséquence commerciale de l’étude
Une étude achevée modifie trois positions commerciales, et il vaut mieux l’utiliser délibérément plutôt que de la laisser dormir dans un dossier.
Les critères d’acceptation de la commande. Les seuils que vous avez mesurés deviennent les critères du bon de commande, et un lot qui ne les respecte pas est un lot que vous pouvez refuser. Sans l’étude, vous n’avez aucun de refus.
La garantie. Une garantie fondée sur le critère de défaillance constaté sur le terrain est mesurable au moment de la réclamation. Une garantie fondée sur une description relève d’une négociation.
La fiche produit. La liste des échecs et l’essai sans réseau déterminent votre texte. Une description étroite fondée sur un résultat mesuré est défendable; une description large fondée sur une démonstration ne l’est pas.
Ce que notre propre position laisse ouvert
Notre documentation mentionne une fonction d’assistant vocal IA sur les plateformes avec caméra et décrit la prise en charge de la traduction IA sur le site indépendant. Elle ne publie aucun chiffre de précision, aucune liste de langues prises en charge, aucune donnée de latence, aucun comportement hors ligne, aucun lieu de traitement, aucune condition d’abonnement et aucune juridiction applicable aux données.
Cela signifie que nous ne pouvons pas fournir une version completed de ce modèle pour nos propres produits, et nous préférons le dire plutôt que publier une étude dont nous ne sommes pas en mesure de décrire les conditions. Cela signifie également que si vous réalisez cette étude sur l’un de nos échantillons, vous produirez des éléments probants que personne d’autre dans la chaîne ne détient — ce qui constitue une position étrange pour un fabricant, mais utile pour un acheteur.
Ce que nous pouvons proposer, c’est l’autre moitié. Envoyez-nous une étude que vous avez menée sur l’un de nos échantillons et nous vous indiquerons quels résultats sont cohérents avec les lignes que nous publions et lesquels ne le sont pas. Un résultat contredisant un élément de notre documentation mérite d’être connu, pour l’une ou l’autre des parties.
Pour comprendre ce que notre catalogue couvre et ne couvre pas: vingt de nos 28 entrées de modèles sont désignées comme produits IA — onze modèles avec caméra, huit modèles audio et une entrée électrochromes sans caméra — et ce décompte relève d’une convention de dénomination de la gamme plutôt que d’une affirmation selon laquelle vingt produits partagent une même implémentation. Pour le groupe des modèles avec caméra, nous publions la capacité de la batterie, l’interface de recharge, la classe de résolution, l’autonomie nominale et le temps de charge; les huit modèles audio publient en plus une version de Bluetooth, tandis que la série avec caméra n’en publie aucune. Un seul poids apparaît dans l’ensemble du catalogue: 158 g pour la plateforme caméra MT6, hors étui de recharge pliable, et aucun modèle ne publie le poids d’une configuration équipée de l’IA.
Cette lacune est constante et explicable: nous publions les lignes du produit que nous assemblons, et non les caractéristiques d’implémentation d’une fonctionnalité fournie par un tiers. La même règle s’applique à la lentille d’un programme photochromique, ainsi qu’à la position relative aux qualifications radio, pour laquelle notre catalogue mentionne une certification d’exportation au niveau de l’entreprise, mais aucune ligne de certification par modèle. Il s’agit d’une règle concernant ce que nous pouvons étayer honnêtement, et elle s’applique à tous les produits que nous répertorions.
C’est également la raison pour laquelle nous ne pouvons pas publier une version complète de ce modèle pour nos propres produits. Il n’existe aucune version complète à publier, et en rédiger une reviendrait à inventer des conditions ou à reprendre celles d’un fournisseur; ni l’une ni l’autre ne survivrait au premier client demandant comment le chiffre avait été obtenu.
Le contexte de la fonctionnalité se trouve dans les fonctionnalités IA des lunettes connectées. Les limites que ce test permet de mettre en évidence sont présentées dans les limites des fonctionnalités IA que nous connaissons, la méthode d’évaluation est décrite dans les allégations des fabricants relatives aux fonctionnalités IA, les critères à définir avant de commencer les tests figurent dans la liste de contrôle pour les fonctionnalités IA destinée aux équipes achats, et le protocole d’échantillonnage lui-même est décrit dans l’évaluation des échantillons.
Lectures complémentaires
- Ce que ce test est conçu pour mettre en évidence — les limites et les inconvénients des fonctionnalités IA
- Les critères à définir avant les tests — la liste de contrôle pour les fonctionnalités IA destinée aux équipes achats
- Le protocole d’échantillonnage lui-même — l’évaluation des échantillons
Envoyez-nous une étude que vous avez menée et nous vous indiquerons quels résultats sont cohérents avec les critères que nous avons publiés.


