
Studium przypadku funkcji AI jest niemal zawsze niepublikowalne, ponieważ przedstawia wynik bez informacji o warunkach, które do niego doprowadziły. Szablon studium przypadku funkcji AI smart glasses nie jest więc w istocie szablonem publikacyjnym — służy do wytwarzania dowodów dotyczących możliwości, których nie można określić z góry. Jeśli przeczytali Państwo pozostałe materiały o AI, Państwo wiedzą już, że w naszej dokumentacji nie publikujemy wartości dokładności, zakresu obsługiwanych języków, czasu opóźnienia ani szczegółów architektury dla żadnego z naszych 28 modeli, co oznacza, że po naszej stronie nie istnieje takie badanie, które można by powielić.
Właśnie dlatego ten szablon jest ważny. W większości kategorii kupujący może przygotować specyfikację i sprawdzić dostawcę według niej. W kategorii AI pytania dotyczące możliwości — dokładność, zakres obsługiwanych języków, działanie offline, czas opóźnienia — nie mogą zostać rozstrzygnięte wyłącznie na podstawie dokumentacji, ponieważ w tej branży nie ma właściwie czego czytać, a w dużej mierze dotyczy to również większości dostawców. Próbka jest zatem przyrządem pomiarowym. Jest to jedyne narzędzie, które pozwala uzyskać liczbę odnoszącą się konkretnie do Państwa produktu.
Funkcje AI smart glasses: dlaczego badania są niepublikowalne
Problem strukturalny
Studium przypadku jest raportem z tego, co się wydarzyło, a raport jest użyteczny tylko wtedy, gdy czytelnik może ustalić, co się wydarzyło z powodu jakich warunków. Większość badań funkcji AI nie spełnia tego warunku na jeden z trzech sposobów.
Brakuje warunków. Badanie podaje „92% dokładności w przypadku zapytań klientów”, ale nie wskazuje zestawu treści, pary języków, warunków sieciowych ani daty. Liczba ta nie jest wynikiem pomiaru — jest liczbą pozbawioną odniesienia, której nie można powielić ani przez Państwa, ani przez nikogo innego.
Brakuje niepowodzeń. Badanie opisuje wyłącznie to, co zadziałało. Raport z samych sukcesów jest demonstracją, a lista niepowodzeń stanowi część o rzeczywistej wartości inżynierskiej. To ona również mówi kupującemu, czy funkcja jest w stanie udźwignąć ciężar marketingowego twierdzenia.
Brakuje wymagania. Badanie przeprowadzono bez pisemnego określenia tego, co funkcja miała robić, więc dostarcza danych, ale nie pozwala podjąć decyzji. Jest to najczęstszy i najbardziej kosztowny błąd, ponieważ kupujący kończy, porównując dane z oczekiwaniem, które nigdy nie zostało spisane, a więc nie można go zweryfikować.
Dlaczego dokumentacja nie zastępuje badania
Pytania dotyczące możliwości w tej kategorii nie są publikowane. Nie przez nas — a według informacji od kupujących — również nie przez większość dostawców. Nie istnieje standardowa metoda badania dokładności AI na urządzeniu noszonym, standardowy warunek pomiaru czasu opóźnienia ani standardowa definicja znaczenia „obsługi offline”.
W praktyce oznacza to, że próbka jest przyrządem pomiarowym, a przygotowanie wiarygodnego wyniku zajmuje około jednego dnia pracy. Dzień to realny koszt w kontekście harmonogramu premiery, ale stanowi niewielki koszt w porównaniu z alternatywą odkrycia zachowania funkcji po uruchomieniu oferty.
Do czego służy szablon
Szablon w tej kategorii nie jest formatem dokumentu. Jest protokołem, którego celem jest jednoczesne zapewnienie, że wynik jest na tyle konkretny, aby można było na nim oprzeć działania, oraz że ktoś inny mógłby go powtórzyć.
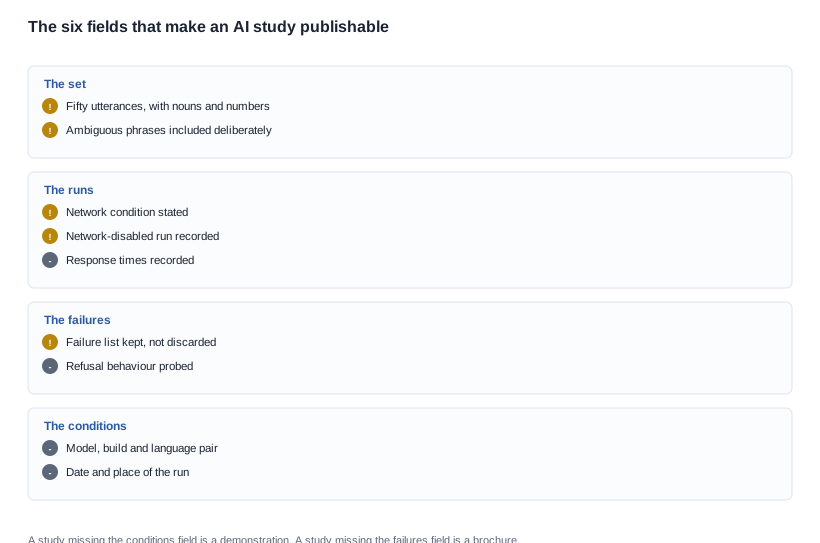
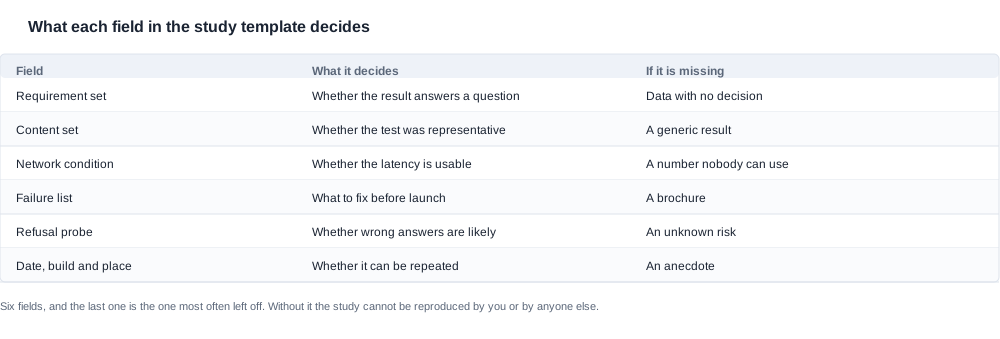
Poniższe sześć pól stanowi niezbędne minimum. Każde z nich eliminuje konkretny błąd, a badanie niezawierające któregokolwiek z nich nie powinno być rozpowszechniane jako dowód — nie dlatego, że jest nieuczciwe, lecz dlatego, że nie pozwala podjąć decyzji.
Sześć pól, dzięki którym badanie można powtórzyć
Pole pierwsze: zestaw wymagań
Pisemne określenie tego, co funkcja musi robić, sporządzone przed pierwszym monitowaniem i opatrzone datą. Nie chodzi o listę pożądanych zachowań, lecz o próg dla każdej funkcji, wyrażony w kategoriach, które są naprawdę istotne dla danego kanału.
W przypadku funkcji tłumaczenia w kanale detalicznym zestaw wymagań może obejmować: obsługę wymienionych języków; wystarczająco dokładną transkrypcję wypowiedzi umożliwiającą podjęcie działania; dostarczenie odpowiedzi w określonym czasie przy określonych warunkach połączenia; a także obowiązek zgłoszenia niepewności przez system zamiast wygenerowania płynnej, lecz błędnej odpowiedzi.
Zestaw wymagań zmienia badanie z opisu w podstawę do decyzji. Jest to również pole, które najczęściej się pomija, ponieważ wydaje się zwykłą formalnością, dopóki nie trzeba zdecydować, czy wynik spełnia wymagania.
Pole drugie: zestaw treści
Pięćdziesiąt zdań przypominających to, co klient faktycznie powie. Należy uwzględnić nazwy własne, liczby, jednostki, kody produktów, nazwy, które mogą oznaczać dwie różne rzeczy, oraz celowo niejednoznaczne sformułowania.
Generyczny zestaw testowy daje generyczny wynik, który niczego nie mówi o Twoim produkcie. Trzydzieści łatwych zdań i dwadzieścia trudnych, przy czym trudne celowo napisano w sposób utrudniający, to lepszy zestaw niż pięćdziesiąt zdań, które skrypt demonstracyjny również przeszedłby.
Zestaw powinien napisać ktoś, kto zna kanał, a nie osoba, która ma najwięcej czasu. Kierownik wsparcia, który przeczytał tysiąc zgłoszeń dotyczących Twojej kategorii, przygotuje lepszy zestaw treści niż inżynier pracujący wyłącznie na podstawie listy funkcji, ponieważ wie, które wyrażenia faktycznie występują, a które są źle rozumiane.
Trzecie pole: warunki połączenia
Stan połączenia w chwili wykonania każdego testu. Formułowanie w formie: warunków typowych dla Twojego najtrudniejszego rynku, a nie warunków panujących w sali demonstracyjnej dostawcy, jest znacznie bardziej użyteczne.
Jeśli Twój kanał obejmuje rynki o nierównej łączności, to „normalne” warunki dla badania oznaczają słabe połączenie. Wynik pokaże wtedy, czy funkcja jest tam użyteczna, czy jedynie dostępna. To pole jest najczęściej pomijane, a jednocześnie ma największy wpływ na wnioski.
Czwarte pole: test bez połączenia z siecią
Pole najczęściej pomijane i decydujące o tym, gdzie produkt może być używany. Wyłącz sieć oraz wymień wszystko, co nadal działa: przechwytywanie, połączenia, odtwarzanie, asystent, ustawienia.
Jeśli Twój klient będzie używał produktu w magazynie, piwnicy lub za granicą przy słabym połączeniu, są to standardowe warunki użytkowania, a nie przypadek brzegowy. Test bez połączenia z siecią pokazuje, czy funkcja AI może stanowić zależność, czy jedynie dodatkową możliwość — a tym samym, czy możesz umieścić ją na opakowaniu jako główny powód zakupu produktu.
Piąte pole: lista niepowodzeń
Zapisuj konkretne niepowodzenia wraz z danymi wejściowymi, wynikiem i przyczyną. Nie chodzi o liczbę, lecz o listę.
Liczba informuje jedynie o współczynniku, a współczynnik bez danych, które za nim stoją, nie pozwala podjąć działań. Lista wskazuje dane wejściowe, z którymi mogą występować problemy. Na jej podstawie powstają skrypt wsparcia, brief szkoleniowy i zastrzeżenia w opisie produktu.
Szóste pole: warunki, wersja i lokalizacja
Model, wersja oprogramowania sprzętowego, data, miejsce, para językowa, identyfikator egzemplarza oraz narzędzie użyte do pomiaru czasu. To pole jest najczęściej pomijane, a jednocześnie odróżnia badanie od anegdoty.
Bez niego nie możesz odtworzyć wyniku — co oznacza, że nie można go odtworzyć w ogóle, ponieważ testowane egzemplarze już zniknęły, a oprogramowanie sprzętowe zostało od tego czasu zaktualizowane.
Tworzenie zestawu treści, który rzeczywiście testuje funkcję
Metoda zapewniająca porównywalne wyniki
Zestaw treści to część szablonu, w której koncentruje się większość ocen, dlatego warto precyzyjnie wyjaśnić, jak go opracować, aby mógł go wykorzystać inny inżynier.
Zacznij od rzeczywistych danych wejściowych, a nie od prawdopodobnych. Najlepszym źródłem są zgłoszenia do wsparcia, transkrypcje rozmów, dzienniki zapytań lub notatki głosowe, które Twój kanał już otrzymuje. Wybierz z nich próbkę, a następnie usuń dane osobowe. Jeśli kanał jest nowy, drugim najlepszym źródłem jest dziesięć pytań, o które sprzedawca jest najczęściej pytany, zapisanych w sposób typowy dla klienta, a nie dla produktu.
Świadomie zróżnicuj poziom trudności. Podziel pięćdziesiąt zdań na trzy poziomy i zachowaj liczbę z każdego z nich w notatkach: polecenia, które przejdzie demonstracja; polecenia zawierające nazwę własną, liczbę lub jednostkę; oraz polecenia rzeczywiście niejednoznaczne — nazwa, która może należeć do dwóch osób, liczba bez kontekstu lub fraza z dwiema możliwymi interpretacjami. Trzeci poziom dostarcza największej wartości inżynierskiej i ujawnia ryzyko płynnej, ale błędnej odpowiedzi.
Celowo uwzględnij przypadki negatywne. Każdy zestaw musi zawierać polecenia, na które system powinien odmówić odpowiedzi lub które nie mają poprawnej odpowiedzi. System, który zwraca pewną siebie, płynną bzdurę, jest bardziej szkodliwy niż system, który nie zwraca nic, a podczas prezentacji jest to niewidoczne, ponieważ demonstracje tworzy się z poleceń, które działają.
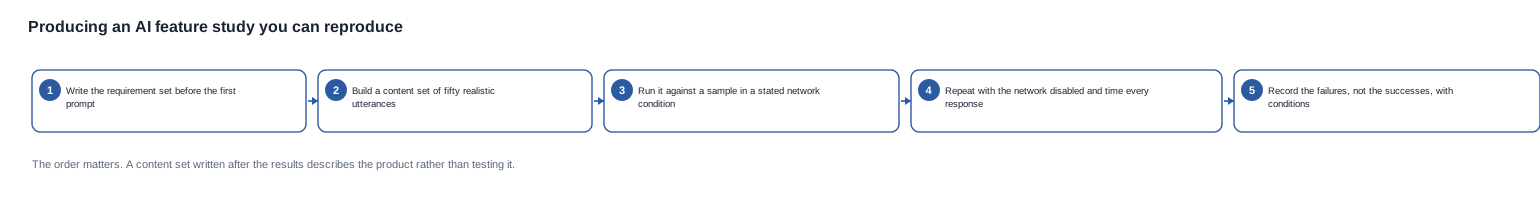
Napisz zestaw przed otrzymaniem próbki lub przynajmniej zanim zobaczysz, że działa. Zestaw napisany po uzyskaniu wyników opisuje produkt, zamiast go testować. Różnicy nie można wykryć na podstawie wyniku — można ją wykryć jedynie wtedy, gdy wiadomo, co zamierzono uwzględnić.
Uruchamianie zestawu i zapisywanie przebiegu testów
Uruchom każde polecenie na próbce w określonych warunkach połączenia i zapisz cztery informacje dla każdego polecenia: co zostało powiedziane, jaka odpowiedź wróciła, ile trwało oraz czy odpowiedź była poprawna, niepełna, błędna, czy system prawidłowo odmówił odpowiedzi.
Każdą odpowiedź mierz względem ustalonego progu, a nie tylko rejestruj surowy czas reakcji. Surowy wskaźnik opóźnienia bez przypisanego progu niczego nie mówi o tym, czy funkcja jest użyteczna; próg pozwala określić, czy test został zaliczony, a wynik można następnie wpisać do specyfikacji.
Powtórz test przy wyłączonej sieci, używając tego samego zestawu, i zapisz, na które pytania nadal otrzymujesz odpowiedź. Jeśli któreś pytanie z pierwszego zestawu przestaje działać po wyłączeniu sieci, należy ono do zbioru ograniczeń Twojego opisu produktu.
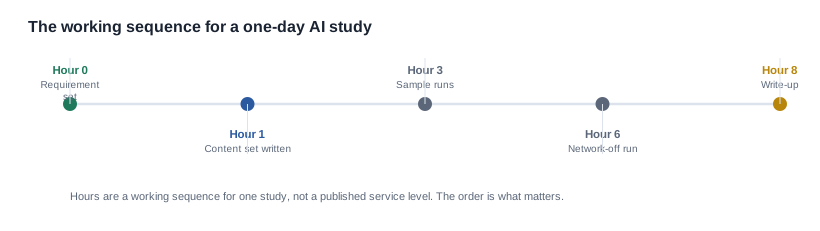
Poniższy przebieg pracy z mieści się swobodnie w ciągu jednego dnia dla jednego produktu i jednej funkcji. Jest celowo uporządkowany tak, aby najtrudniejsze testy odbywały się wtedy, gdy zespół wciąż zachowuje pełną uwagę.
Trzy grupy odbiorców, trzy wersje tego samego badania
Badanie zwykle musi służyć trzem grupom czytelników. Błędem jest napisanie jednego dokumentu, który ma zaspokoić potrzeby wszystkich trzech. Potrzebują oni różnych informacji i różnego poziomu szczegółowości.
Wewnętrzny zespół — produkt, wsparcie i marketing — potrzebuje listy awarii oraz zbioru ograniczeń. Musi wiedzieć, które dane wejściowe powodują awarię i jak funkcja zachowuje się bez połączenia, ponieważ na tej podstawie powstaje skrypt wsparcia i krótkie szkolenie. Nie potrzebuje surowych czasów reakcji dla każdego pytania; potrzebuje progu i informacji, czy został on osiągnięty.
Dostawca potrzebuje zestawu wymagań, zestawu treści i listy awarii w formie, którą może wykorzystać w działaniu. Warto przesłać mu sam zestaw treści, ponieważ dostawca, który widzi dokładne pytania, może powtórzyć test i wyjaśnić przyczyny awarii. Jest to szybsze niż opisywanie pięćdziesięciu wypowiedzi w wiadomości e-mail.
Zespół zajmujący się klientem końcowym — kanał sprzedaży, personel sklepów i sprzedawca — potrzebuje jednej strony. Musi wiedzieć, co funkcja potrafi dobrze zrobić, czego nie jest w stanie zrobić i co odpowiedzieć, gdy klient poprosi o coś, co wykracza poza jej możliwości. Tę stronę pisze się na końcu, ponieważ musi zawierać prawdziwe informacje, a staje się prawdziwa dopiero po poznaniu wszystkich awarii.
Takie uporządkowanie pisania sprawia również, że badanie nie zostaje ukształtowane przez zespół marketingowy. Jeśli opis produktu powstaje jako pierwszy, zestaw treści zwykle opracowuje się na podstawie zdań, które tekst marketingowy już obiecuje. Badanie potwierdza wtedy tekst marketingowy, zamiast testować produkt. To właśnie tryb awarii, któremu cały ten szablon ma zapobiegać.
Jak utrzymać przydatność badania po premierze
Badanie jest zwykle najbardziej wartościowe w miesiącach po premierze, gdy napływa pierwsza fala rzeczywistych pytań, a różnice między zestawem testowym a rzeczywistością stają się widoczne.
Dwa zwyczaje pozwalają to osiągnąć. Przechowuj zestaw treści i warunki wraz z badaniem, a nie tylko wyniki, aby późniejszy test można było porównać z pierwszym. Zaplanuj powtórzenie badania w określonych odstępach i po określonych zdarzeniach — po aktualizacji oprogramowania sprzętu, po zmianie dostawcy oraz przed każdą dużą kampanią, która wywoła nietypowy ruch. Jeśli funkcja AI zmieniła się od czasu ostatniego badania, opis produktu może przestać być prawdziwy. Koszt wykrycia tej zmiany za pomocą badania jest znacznie niższy niż koszt wykrycia jej na podstawie skargi klienta.
Zmiana badania w decyzję, a nie dokument
Porównuj wyniki z zestawem wymagań, a nie z innym produktem
Jeśli przed rozpoczęciem testów określiłeś, co funkcja musi robić, masz teraz odpowiedź, na której możesz oprzeć działanie. Jeśli tego nie zrobiłeś, masz dane, ale nie masz pytania. To właśnie jest powód istnienia pierwszego pola i warto to powtórzyć, ponieważ jest to moment, w którym większość badań popełnia błąd.
Porównywanie Twojego wyniku z wynikiem innego dostawcy jest w tej kategorii niemal zawsze błędem, ponieważ oba wyniki uzyskano w różnych warunkach, przy różnych zestawach treści i z różnymi progami. Ostatecznie wybierzesz na podstawie liczby, a nie dowodów.
Skuteczne porównanie jest trójwymiarowe: Twój wynik względem Twojego zestawu wymagań, Twój wynik względem tego samego zestawu wymagań dla pozostałych dostawców oraz luka między nimi w odniesieniu do kosztu, który poniósłbyś z jej powodu. Trzeci krok jest pomijany przez kupujących, a właśnie on zamienia wynik testu w decyzję zakupową.
Opisz badanie w sposób umożliwiający jego powtórzenie
Oznacza to uwzględnienie zestawu treści, warunków i metody, a nie wniosków. Wynik, którego inny inżynier nie może odtworzyć, jest twierdzeniem z załączoną tabelą.
Opis powinien być na tyle krótki, aby współpracownik go przeczytał, i na tyle kompletny, aby mógł go przeprowadzić. W praktyce oznacza to: zestaw wymagań, zestaw treści w postaci pięćdziesięciu promptów, tabelę warunków, tabelę wyników z wymienionymi niepowodzeniami oraz akapit podsumowujący, w którym wskazano wymagania spełnione i niespełnione.
Decyzja o scenariuszu degradacji na podstawie wyniku
Przebieg z wyłączoną siecią jest tym, który decyduje, czy funkcja może stanowić zależność, czy jedynie ulepszenie. Jeśli degradacja jest akceptowalna, funkcja bezpiecznie wzmacnia przekaz marketingowy. Jeśli degradacja oznacza, że produkt przestaje robić to, za co został kupiony, należy zmienić treść komunikacji lub produkt — a obie opcje są tańsze do rozważenia na tym etapie niż po uruchomieniu.
Druga decyzja wynika z listy niepowodzeń: czy tryb awarii jest widoczny. System, który mówi „nie zauważyłem tego”, to po prostu fragment procedury wsparcia. System, który udziela pewnych i błędnych odpowiedzi, stanowi zupełnie inny rodzaj problemu — i to właśnie on nie pojawi się w Twoim zestawie testów, jeśli będzie on zbyt uprzejmy.
Konsekwencje handlowe badania
Zakończone badanie zmienia trzy kwestie handlowe, dlatego warto wykorzystać je świadomie, zamiast pozostawiać je w folderze.
Kryteria akceptacji zamówienia. Zmierzone progi stają się kryteriami w zamówieniu zakupowym, a partia, która ich nie spełnia, jest partią, którą można odmówić. Bez badania nie ma żadnych podstaw do odmowy.
Gwarancja. Gwarancja opracowana na podstawie kryterium niepowodzenia z testu w terenie jest mierzalna w momencie zgłoszenia reklamacji. Gwarancja sformułowana na podstawie opisu jest przedmiotem negocjacji.
Opis oferty. Lista niepowodzeń i przebieg z wyłączoną siecią stanowią treść Twojej komunikacji. Wąski opis oparty na zmierzonym wyniku można uzasadnić; szeroki opis oparty na prezentacji — nie.
Co pozostaje otwarte w naszej własnej ofercie
Nasza dokumentacja odwołuje się do funkcji asystenta głosowego AI w platformach kamerowych oraz opisuje obsługę tłumaczenia AI w niezależnej witrynie. Nie publikujemy wartości dokładności, listy obsługiwanych języków, opóźnień, działania offline, lokalizacji przetwarzania, warunków subskrypcji ani jurysdykcji danych.
Oznacza to, że nie możemy dostarczyć ukończonej wersji tego szablonu dla naszych własnych produktów i wolimy to powiedzieć, niż opublikować badanie, którego warunków nie potrafimy opisać. Oznacza to również, że jeśli przeprowadzisz takie badanie na jednej z naszych próbek, uzyskasz dowody, których nie ma nikt inny w łańcuchu dostaw — co jest nietypową sytuacją dla producenta, ale korzystną dla kupującego.
Możemy natomiast zapewnić drugą część. Prześlij nam badanie, które przeprowadziłeś na jednej z naszych próbek, a my wskażemy, które wyniki są zgodne z opublikowanymi przez nas danymi, a które nie. Warto wiedzieć o wyniku sprzecznym z naszą dokumentacją — zarówno Tobie, jak i nam.
Aby uzyskać kontekst dotyczący tego, co nasz katalog zawiera, a czego nie: dwadzieścia z 28 pozycji modeli w katalogu jest oznaczonych jako produkty AI — jedenastu modeli kamerowych, osiem modeli audio i jedna pozycja elektrochromowa bez kamery — a liczba ta wynika z przyjętej w całej ofercie konwencji nazewnictwa, a nie oznacza, że dwadzieścia produktów korzysta z jednej implementacji. W grupie kamer publikujemy pojemność ogniwa, interfejs ładowania, klasę rozdzielczości, deklarowany czas pracy i czas ładowania; osiem modeli audio publikuje dodatkowo wersję Bluetooth, natomiast seria kamer nie publikuje żadnej. W całym katalogu występuje tylko jedna masa: 158 g dla platformy kamerowej MT6, bez jej składanego etui ładującego, a żaden model nie publikuje masy konfiguracji wyposażonej w AI.
Luka jest spójna i można ją wyjaśnić: publikujemy dane produktu, który montujemy, a nie cechy implementacyjne funkcji dostarczanej przez podmiot zewnętrzny. Ta sama zasada dotyczy obiektywu w programie fotochromicznym oraz stanu kwalifikacji radiowej, w którym nasz katalog zawiera ogólne oświadczenie producenta o certyfikacie eksportowym, ale nie zawiera certyfikacji dla poszczególnych modeli. Jest to zasada określająca, co możemy uczciwie udokumentować, i obowiązuje każdy produkt, który oferujemy.
Z tego samego powodu nie możemy opublikować ukończonej wersji tego szablonu dla naszych własnych produktów. Nie istnieje ukończona wersja, którą można by opublikować, a jej przygotowanie oznaczałoby wymyślenie warunków lub zaciągnięcie warunków dostawcy — a żadne z tych rozwiązań nie wytrzymałoby pierwszego pytania klienta o to, jak uzyskano daną liczbę.
Tło funkcji opisano w artykule Funkcje AI smart glasses. Ograniczenia ujawniane przez ten test przedstawiamy w artykule Ograniczenia funkcji AI, które znamy, metodę oceny twierdzeń opisano w artykule Twierdzenia producentów dotyczące funkcji AI, wiersze, które należy ustalić przed rozpoczęciem testów, znajdziesz w artykule Checklist funkcji AI dla zespołów zakupowych, a sam protokół próbki opisano w artykule Ocena próbek.
Powiązane lektury
- Do czego przeznaczony jest ten test — Ograniczenia i wady funkcji AI
- Wiersze, które należy ustalić przed testami — Checklist funkcji AI dla zespołów zakupowych
- Sam protokół próbki — Ocena próbek
Prześlij nam przeprowadzone przez siebie badanie, a my wskażemy, które z jego ustaleń są zgodne z opublikowanymi przez nas wierszami.


