
Een casestudy over een AI-functie is vrijwel altijd onpublicabel, omdat er een resultaat wordt gerapporteerd zonder de omstandigheden waaronder dit is ontstaan. Smart glasses ai features smart glasses case study template is daarom geen echte publicatiesjabloon — het is een manier om bewijs te produceren over een functionaliteit die niet vooraf kan worden gespecificeerd. Als u de rest van onze AI-publicaties hebt gelezen, weet u al dat onze documentatie voor geen van onze 28 modellen een nauwkeurigheidscijfer, taaldekking, latentie of architectuurdetails publiceert. Dat betekent dat er aan onze kant geen dergelijke studie bestaat die u kunt reproduceren.
Die afwezigheid is de reden waarom dit sjabloon belangrijk is. In de meeste categorieën kan een inkoper een specificatie opstellen en de leverancier daaraan toetsen. In de AI-categorie kunnen de vragen over functionaliteit — nauwkeurigheid, taaldekking, offlinegedrag, latentie — helemaal niet met documentatie worden beantwoord, omdat er in dit segment niets te lezen valt. Volgens inkopers geldt dat grotendeels ook voor de meeste leveranciers. Het monster is dus het meetinstrument. Het is het enige hulpmiddel dat u hebt om een specifiek cijfer voor uw product te verkrijgen.
AI-functies van slimme brillen: waarom studies onpublicabel zijn
Het structurele probleem
Een casestudy is een verslag van iets dat heeft plaatsgevonden en is alleen nuttig als de lezer kan vaststellen wat er is gebeurd omwille van welke omstandigheden. De meeste studies naar AI-functies falen op een van drie manieren voor deze toets.
De omstandigheden ontbreken. De studie meldt "92% nauwkeurigheid bij klantvragen" zonder contentset, taalpaar, netwerkconditie of datum. Dat cijfer is geen meting — het is een getal waarvan de referentie is verwijderd, waardoor noch u noch iemand anders het kan reproduceren.
De mislukkingen ontbreken. De studie meldt wat wel werkte. Een verslag van successen is een demonstratie, en de lijst met mislukkingen is het onderdeel met technische waarde. Het is ook het onderdeel dat een inkoper vertelt of de functie het gewicht van een marketingclaim kan dragen.
De eis ontbreekt. De studie is uitgevoerd zonder een schriftelijke verklaring van wat de functie moest doen, en levert dus gegevens op maar geen besluit. Dit is de meest voorkomende en duurste fout, omdat de inkoper uiteindelijk de gegevens vergelijkt met een verwachting die nooit is vastgelegd en daarom niet kan worden gecontroleerd.
Waarom documentatie de studie niet kan vervangen
De vragen over functionaliteit in deze categorie worden niet gepubliceerd. Niet door ons en — volgens inkopers — evenmin door de meeste leveranciers. Er bestaan geen standaardtestmethode voor de AI-nauwkeurigheid van een draagbaar apparaat, geen standaardconditie voor latentiemetingen en geen standaarddefinitie van wat "offlineondersteuning" betekent.
Praktisch betekent dit dat het monster het meetinstrument is en dat het ongeveer een werkdag kost om iets verdedigbaars te produceren. Eén dag is een aanzienlijke kost tegen een lanceringsschema, maar een zeer kleine kost vergeleken met de alternatief: het gedrag pas ontdekken nadat de productpagina live staat.
Waar een sjabloon voor dient
Een sjabloon in deze categorie is geen documentindeling. Het is een protocol dat er bestaat om twee dingen tegelijk mogelijk te maken: het resultaat moet specifiek genoeg zijn om op te handelen en iemand anders moet het kunnen herhalen.
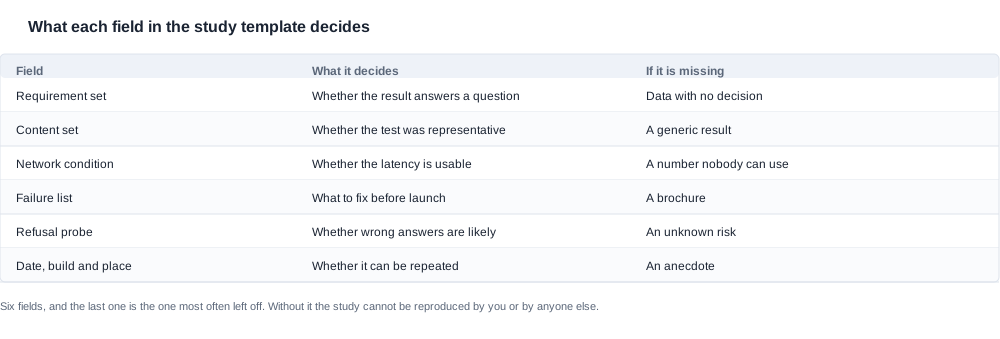
De zes velden hieronder zijn het minimum daarvoor. Elk veld sluit een specifieke fout af. Een studie waarvan een van deze velden ontbreekt, mag niet als bewijs worden verspreid — niet omdat deze oneerlijk is, maar omdat er geen besluit aan kan worden gekoppeld.
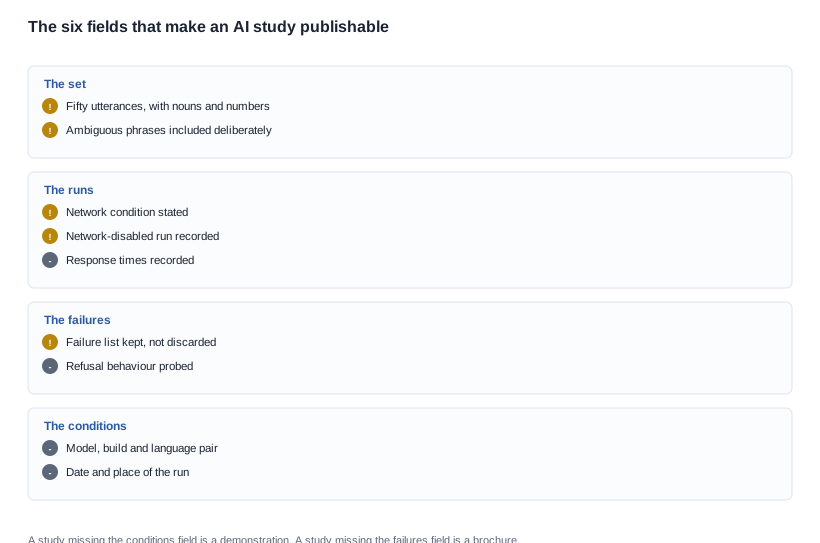
De zes velden waarmee een studie reproduceerbaar wordt
Veld één: de eisenset
Een schriftelijke verklaring van wat de functie moet doen, opgesteld vóór de eerste opdracht en gedateerd. Geen lijst met gewenste gedragingen — een drempel per functie, uitgedrukt in de termen die het verkoopkanaal werkelijk belang vindt.
Voor een vertaalfunctie in een retailedkan kan de eisenset bijvoorbeeld zijn: het paar moet worden ondersteund voor de vermelde talen; een gesproken verzoek moet nauwkeurig genoeg worden getranscribeerd om actie te ondernemen; het antwoord moet binnen een opgegeven tijd via een opgegeven verbinding worden ontvangen; en wanneer het systeem onzeker is, moet dit aangeven in plaats van een vloeiend antwoord te geven.
De eisenset verandert de studie van een beschrijving in een besluit. Het is ook het veld dat het vaakst wordt overgeslagen, omdat het aanvankelijk alleen maar papierwerk lijkt tot de dag waarop u moet beslissen of een resultaat voldoet.
Veld twee: de contentset
Vijftig zinnen die lijken op wat uw klanten werkelijk zullen zeggen. Neem eigennamen, getallen, eenheden, productcodes, namen die op twee verschillende dingen kunnen slaan en bewust dubbelzinnige uitdrukkingen op.
Een generieke testset levert een generiek resultaat op dat je niets vertelt over je product. Dertig eenvoudige zinnen en twintig moeilijke zinnen, waarbij de moeilijke zinnen ook echt moeilijk zijn, vormen een betere set dan vijftig zinnen die een demonstratiescript ook zou doorstaan.
De set moet worden geschreven door iemand die het kanaal kent, niet door degene die de meeste tijd heeft. Een supportlead die duizend tickets voor jouw categorie heeft gelezen, schrijft een betere contentset dan een ingenieur die met een functielijst werkt, omdat diegene weet welke formuleringen daadwerkelijk voorkomen en welke verkeerd worden opgevat.
Veld drie: de netwerkconditie
Wat de verbinding was tijdens elke testronde. Dat is nuttiger als volgt vermeld: de toestand die normaal is voor je slechtste markt, niet de toestand in de demonstratieruimte van de leverancier.
Als je kanaal markten omvat met een inconsistente connectiviteit, is een "normale" verbinding voor het onderzoek een slechte verbinding. Het resultaat laat dan zien of de functie daar bruikbaar is of alleen aanwezig is. Dit veld wordt het vaakst impliciet gelaten en is het veld dat de conclusie het meest verandert.
Veld vier: de testronde zonder netwerk
Het veld dat het vaakst wordt weggelaten en bepaalt waar het product kan worden gebruikt. Schakel het netwerk uit en noteer wat nog werkt: opname, oproepen, afspelen, de assistent en de instellingen.
Als je klant dit gaat gebruiken in een magazijn, kelder of in het buitenland met een slechte verbinding, is dat de gebruiksconditie en geen randgeval. De testronde zonder netwerk laat zien of de AI-functie een noodzakelijkheid is of alleen een extraatje — en dus of je die op de verpakking kunt vermelden als reden om het product te kopen.
Veld vijf: de foutenlijst
Noteer de fouten concreet, met de invoer, de uitvoer en de reden waarom het misging. Geen aantal — een lijst.
Een aantal geeft je een percentage, en een percentage zonder de bijbehorende invoerwaarden is niet bruikbaar. De lijst laat zien bij welke invoer je problemen kunt verwachten, en op basis daarvan worden een supportscript, een trainingsdocument en een verduidelijking bij productvermeldingen opgesteld.
Veld zes: de omstandigheden, build en locatie
Het model, de firmwarebuild, de datum, de locatie, het taalpaar, de eenheidsidentifier en de tool die voor de timing is gebruikt. Dit veld wordt het vaakst weggelaten en maakt het verschil tussen een onderzoek en een anekdote.
Zonder dit veld kun je een resultaat niet reproduceren — en dus feitelijk helemaal niet, omdat de geteste exemplaren zijn verdwenen en de firmware sindsdien is bijgewerkt.
De contentset bouwen die de functie daadwerkelijk test
Een methode die vergelijkbare resultaten oplevert
De contentset is het onderdeel van het model waarin het meeste oordeel zit. Het is de moeite waard precies te bepalen hoe je een set bouwt die een andere ingenieur ook kan gebruiken.
Begin met echte invoerwaarden, niet met plausibele. De beste bron is de supporttickets, de gespreksverslagen, de querylogs of de spraaknotities die je kanaal al ontvangt. Neem daar een steekproef uit en verwijder vervolgens de persoonsgegevens. Als het kanaal nieuw is, is de op één na beste bron de tien vragen die verkopers het vaakst krijgen, geschreven in de woorden van de klant in plaats van die van het product.
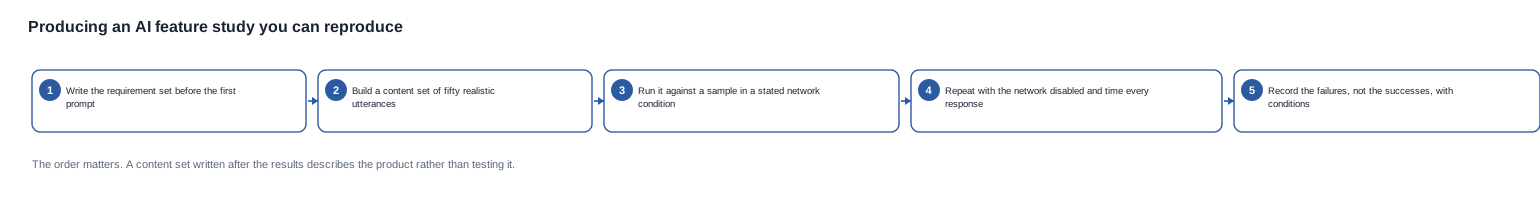
Breng de moeilijkheidsgraden bewust aan. Verdeel de vijftig in drie niveaus en houd het aantal van elk niveau bij in je notities: verzoeken waarmee een demonstratie zou slagen, verzoeken met een eigennaam, een getal of een eenheid erin, en verzoeken die werkelijk dubbelzinnig zijn — een naam die bij twee personen kan passen, een getal zonder context of een formulering met twee interpretaties. Op het derde niveau zit de technische waarde en komt het risico op een vloeiend maar onjuist antwoord naar voren.
Voeg de negatieve gevallen bewust toe. Elke set heeft prompts waarop geen antwoord mag worden gegeven of waarvoor geen correct antwoord bestaat. Een systeem dat zelfverzekerd en vloeiend nonsens retourneert, is schadelijker dan een systeem dat niets retourneert. Dit is onzichtbaar in een demonstratie, omdat demonstraties bestaan uit prompts die werken.
Schrijf de set voordat de steekproef binnenkomt, of in elk geval voordat je hebt gezien dat deze werkt. Een set die na de resultaten wordt geschreven, beschrijft het product in plaats van het te testen. Dat verschil is niet aan de output te zien, maar alleen vast te stellen als je weet wat je oorspronkelijk wilde opnemen.
De set uitvoeren en vastleggen wat er gebeurt
Voer elke prompt uit op een steekproef, onder een vermelde netwerkconditie, en leg per prompt vier dingen vast: wat er is gezegd, wat er terugkwam, hoe lang het duurde en of het antwoord correct, onvolledig, onjuist of terecht geweigerd was.
Meet elke reactie af tegen een vaste drempelwaarde in plaats van alleen het ruwe aantal vast te leggen. Een ruw latentiecijfer zonder drempelwaarde zegt niets over de bruikbaarheid van de functie; een drempelwaarde maakt er een geslaagde of mislukte test van, en een geslaagde of mislukte test kan in een specificatie worden opgenomen.
Herhaal de test zonder netwerk met dezelfde set en leg vast wat nog steeds antwoordt. Als een prompt uit de eerste set bij de test zonder netwerk nu mislukt, behoort die prompt tot de beperkingenset van je vermelding.
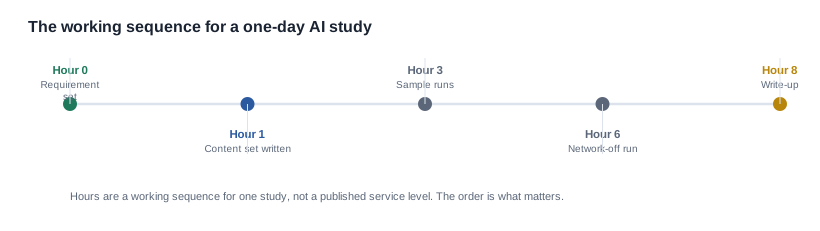
De onderstaande werkwijze past gemakkelijk binnen een dag voor één product en één functie en is bewust zo geordend dat de zwaarste tests plaatsvinden terwijl het team nog aandacht heeft.
Drie doelgroepen, drie versies van hetzelfde onderzoek
Een onderzoek moet doorgaans drie lezers bedienen, en de fout is één document te schrijven dat probeert alle drie te bedienen. Ze hebben verschillende behoeften en verschillende niveaus van detail nodig.
Het interne team — product, support en marketing — heeft de foutenlijst en de beperkingenset nodig. Het moet weten welke invoer mislukt en wat de functie doet zonder verbinding, want op basis daarvan worden supportscripts en trainingsmaterialen geschreven. Het heeft de ruwe timing voor elke prompt niet nodig; het heeft de drempelwaarde nodig en of die is gehaald.
De leverancier heeft de eisenset, de contentset en de foutenlijst nodig in een vorm waarop hij kan handelen. Het is de moeite waard om de contentset zelf mee te sturen, want een leverancier die de exacte prompts kan zien, kan de test herhalen en de fouten uitleggen. Dat is sneller dan vijftig uitingen in een e-mail proberen te beschrijven.
Het klantgerichte team — de verkoopkanalen, het winkelpersoneel en de wederverkoper — heeft één pagina nodig. Wat de functie goed doet, wat zij niet kan en wat je moet zeggen wanneer een klant om iets vraagt dat erbuiten valt. Die pagina schrijf je als laatste, omdat die waar moet zijn en pas waar wordt zodra de fouten bekend zijn.
Als je ze in die volgorde schrijft, wordt het onderzoek ook niet door de marketingdoelgroep vormgegeven. Als de vermelding eerst wordt geschreven, wordt de contentset doorgaans opgebouwd uit de zinnen die de tekst al belooft. Het onderzoek bevestigt dan de tekst in plaats van het product te testen. Dit is precies de foutmodus die dit hele sjabloon moet voorkomen.
Het onderzoek nuttig houden na de lancering
Een onderzoek is doorgaans het meest waardevol in de maanden na de lancering, wanneer de eerste golf echte vragen binnenkomt en de verschillen tussen de testset en de werkelijkheid zichtbaar worden.
Twee gewoonten zorgen ervoor dat dit werkt. Bewaar de contentset en de omstandigheden samen met het onderzoek, niet alleen de resultaten, zodat een latere test met de eerste vergelijkbaar is. En plan een herhalingstest op een vast interval en naar een vaste trigger — na een firmware-update, na een wijziging van de provider en vóór een grote campagne die ongebruikelijk verkeer zal veroorzaken. Een AI-functie die sinds het vorige onderzoek onder je voeten is veranderd, is een functie waarvan de vermelding mogelijk niet meer klopt. Het kost minder om dat via een onderzoek te ontdekken dan via een klacht.
Van een onderzoek naar een beslissing maken in plaats van naar een document
Vergelijk met je eisenset, niet met een ander product
Als je vóór het testen hebt bepaald wat de functie moet doen, heb je nu een antwoord waarop je kunt handelen. Als je dat niet hebt gedaan, heb je gegevens maar geen vraag. Dit is de enige reden dat veld één bestaat. Het is de moeite waard om dit opnieuw te benadrukken, want op dit punt lopen de meeste onderzoeken mis.
Je resultaten vergelijken met die van een andere leverancier is in deze categorie vrijwel altijd een fout, omdat de twee resultaten zijn verkregen onder verschillende omstandigheden, met verschillende contentsets en met verschillende drempelwaarden. Uiteindelijk kies je op basis van het getal in plaats van op basis van het bewijs.
De vergelijking die werkt, is drieledig: je resultaat tegen je eisenset, je resultaat tegen dezelfde eisenset voor de andere leveranciers, en het verschil daartussen tegen wat dat verschil je zou kosten. De derde stap is de stap die inkopers overslaan, en juist die stap maakt van een testresultaat een inkoopbeslissing.
Schrijf het zo op dat iemand anders het kan herhalen
Dat betekent de contentset, de omstandigheden en de methode — niet de conclusie. Een resultaat dat een andere engineer niet kan reproduceren, is een claim met een tabel erbij.
De beschrijving moet kort genoeg zijn dat een collega hem leest, en volledig genoeg dat een collega de test kan uitvoeren. Concreet betekent dat: de reeks eisen, de inhoudsset in de vorm van de feitelijke vijftig prompts, de voorwaardentabel, de resultatentabel met de mislukkingen en een sluitparagraaf waarin staat welke eisen zijn gehaald en welke niet.
Bepaal de degradatiecase op basis van het resultaat
De test zonder netwerk bepaalt of de functie een noodzakelijke afhankelijkheid kan zijn of slechts een extra functionaliteit. Als de degradatie acceptabel is, kan de functie veilig marketingkracht krijgen. Als het product door de degradatie niet meer doet waarvoor het is gekocht, moet de tekst of het product worden aangepast, en dat is nu zowel goedkoper te bepalen als na de lancering.
Uit de lijst met mislukkingen volgt nog een beslissing: of de foutmanifestatie zichtbaar is. Een systeem dat zegt: "Dat heb ik niet opgemerkt", is een regel voor een ondersteuningsscript. Een systeem dat zelfverzekerd maar onjuist antwoordt, is een volledig andere soort probleem, en juist die problemen komen niet voor in je eigen testset als die te welwillend is opgesteld.
De commerciële gevolgen van het onderzoek
Een afgerond onderzoek verandert drie commerciële posities, en het is de moeite waard er bewust gebruik van te maken in plaats van het in een map te laten staan.
De acceptatiecriteria voor de bestelling. De gemeten drempelwaarden worden de criteria in de inkooporder, en een partij die niet aan deze criteria voldoet, is een partij die je kunt weigeren. Zonder het onderzoek heb je geen grond om een partij te weigeren.
De garantie. Een garantie die is gebaseerd op het faalcriterium uit het zesde veld, is bij een schadeclaim meetbaar. Een garantie die is gebaseerd op een beschrijving, is een onderhandeling.
De productvermelding. De lijst met mislukkingen en de test zonder netwerk schrijven je tekst voor. Een nauwkeurige beschrijving op basis van een gemeten resultaat is verdedigbaar; een brede beschrijving op basis van een demonstratie niet.
Wat onze eigen standpunt openlaat
Onze documentatie noemt een AI-spraakassistentfunctie voor de cameraplatformen en beschrijft ondersteuning voor AI-vertaling op de onafhankelijke website. We publiceren geen nauwkeurigheidscijfer, geen lijst met ondersteunde talen, geen latentie, geen offlinegedrag, geen verwerkingslocatie, geen abonnementsvoorwaarden en geenJurisdictie voor gegevens.
Dat betekent dat we voor onze eigen producten geen voltooide versie van deze sjabloon kunnen leveren, en we zeggen dat liever dan een onderzoek te publiceren waarvan we de voorwaarden niet kunnen beschrijven. Het betekent ook dat wanneer je dit onderzoek uitvoert op een van onze samples, je bewijs produceert dat niemand anders in de keten heeft — een vreemde positie voor een fabrikant, maar een nuttige voor een inkoper.
Wat we kunnen aanbieden, is de andere helft. Stuur ons een onderzoek dat je hebt uitgevoerd op een van onze samples, dan vertellen we welke resultaten overeenkomen met onze gepubliceerde gegevens en welke niet. Een resultaat dat bots met iets in onze documentatie, is de moeite waard om te weten, voor ons allebei.
Ter context: in onze catalogus staan 28 modelvermeldingen, waarvan er twintig als AI-product zijn aangeduid — elf cameramodellen, acht audiomodellen en één elektrochrome vermelding zonder camera — en dat aantal is een naamgevingsconventie voor het assortiment en betekent niet dat twintig producten dezelfde implementatie delen. Voor de cameragroep publiceren we de celcapaciteit, de oplaadinterface, de resolutieklasse, de opgegeven gebruiksduur en de laadtijd; voor de acht audiomodellen publiceren we daarnaast de Bluetooth-versie, terwijl de cameraserie geen Bluetooth-versie publiceert. In de hele catalogus komt één gewicht voor: 158 g voor het MT6-cameraplatform, exclusief de opvouwbare oplaadcase, en geen enkel model publiceert een gewicht voor een configuratie met AI-functies.
Het gat is consistent en verklaarbaar: we publiceren de gegevens van het product dat we samenstellen, niet de implementatie-eigenschappen van een functie die een andere partij levert. Dezelfde regel geldt voor de lens in een fotochromisch programma en voor de stand van zaken rond radio-certificering, waarbij onze catalogus op bedrijfsniveau een exportcertificeringsverklaring vermeldt, maar geen certificeringsgegevens per model. Het is een regel over wat we eerlijk kunnen onderbouwen, en die geldt voor elk product dat we vermelden.
Daarom kunnen we voor onze eigen producten ook geen voltooide versie van deze sjabloon publiceren. Er is geen voltooide versie om te publiceren, en er een schrijven zou betekenen dat we óf voorwaarden verzinnen óf die van een leverancier overnemen, en geen van beide overleeft de eerste klant die vraagt hoe het cijfer is berekend.
De functionele achtergrond vind je bij AI-functies van slimme brillen. De beperkingen die deze test aan het licht brengt, staan in de AI-functies waarvan we de beperkingen kennen, de claims-methode staat in claims van fabrikanten van AI-functies, de rijen die je moet vaststellen voordat je gaat testen staan in de checklist voor inkoopteams met AI-functies en het monsterprotocol zelf vind je bij monsterbeoordeling.
Gerelateerd leeswerk
- Waar deze test op gericht is — beperkingen en nadelen van AI-functies
- De rijen die je vóór het testen moet vaststellen — checklist voor inkoopteams met AI-functies
- Het monsterprotocol zelf — monsterbeoordeling
Stuur ons een onderzoek dat je hebt uitgevoerd, dan vertellen we welke bevindingen overeenkomen met onze gepubliceerde rijen.


